一台 PVE 主機的記憶體與 SSD 就這麼多,要分給 ZFS 的 ARC、log、cache 還是 special,才真的加速得到?
我手上有一份幾年前整理的 ZFS 筆記,從 FreeNAS 時期一路用到 Proxmox VE(PVE)。最近拿出來重新對照 OpenZFS 2.4.4 的原始碼與 man page、PVE 和 Proxmox Backup Server(PBS)的官方文件,發現不少地方已經和現在的版本不同。
這篇把它重新整理成 CLI 操作筆記:ARC 記憶體上限、SLOG 與 L2ARC、special device,以及怎麼正確測試效果。範例輸出取自一台實際運作中的主機(PVE 9.2 上同時安裝 PBS 4.2,zfs 2.4.4),主機名稱與磁碟序號已換成範例。
ZFS 的加速層
ZFS 能用來加速的位置有四個:記憶體裡的 ARC,加上 SSD 可以擔任的三種角色。它們負責的工作完全不同,加錯位置不但沒效果,有的還會拖累整個儲存集區。
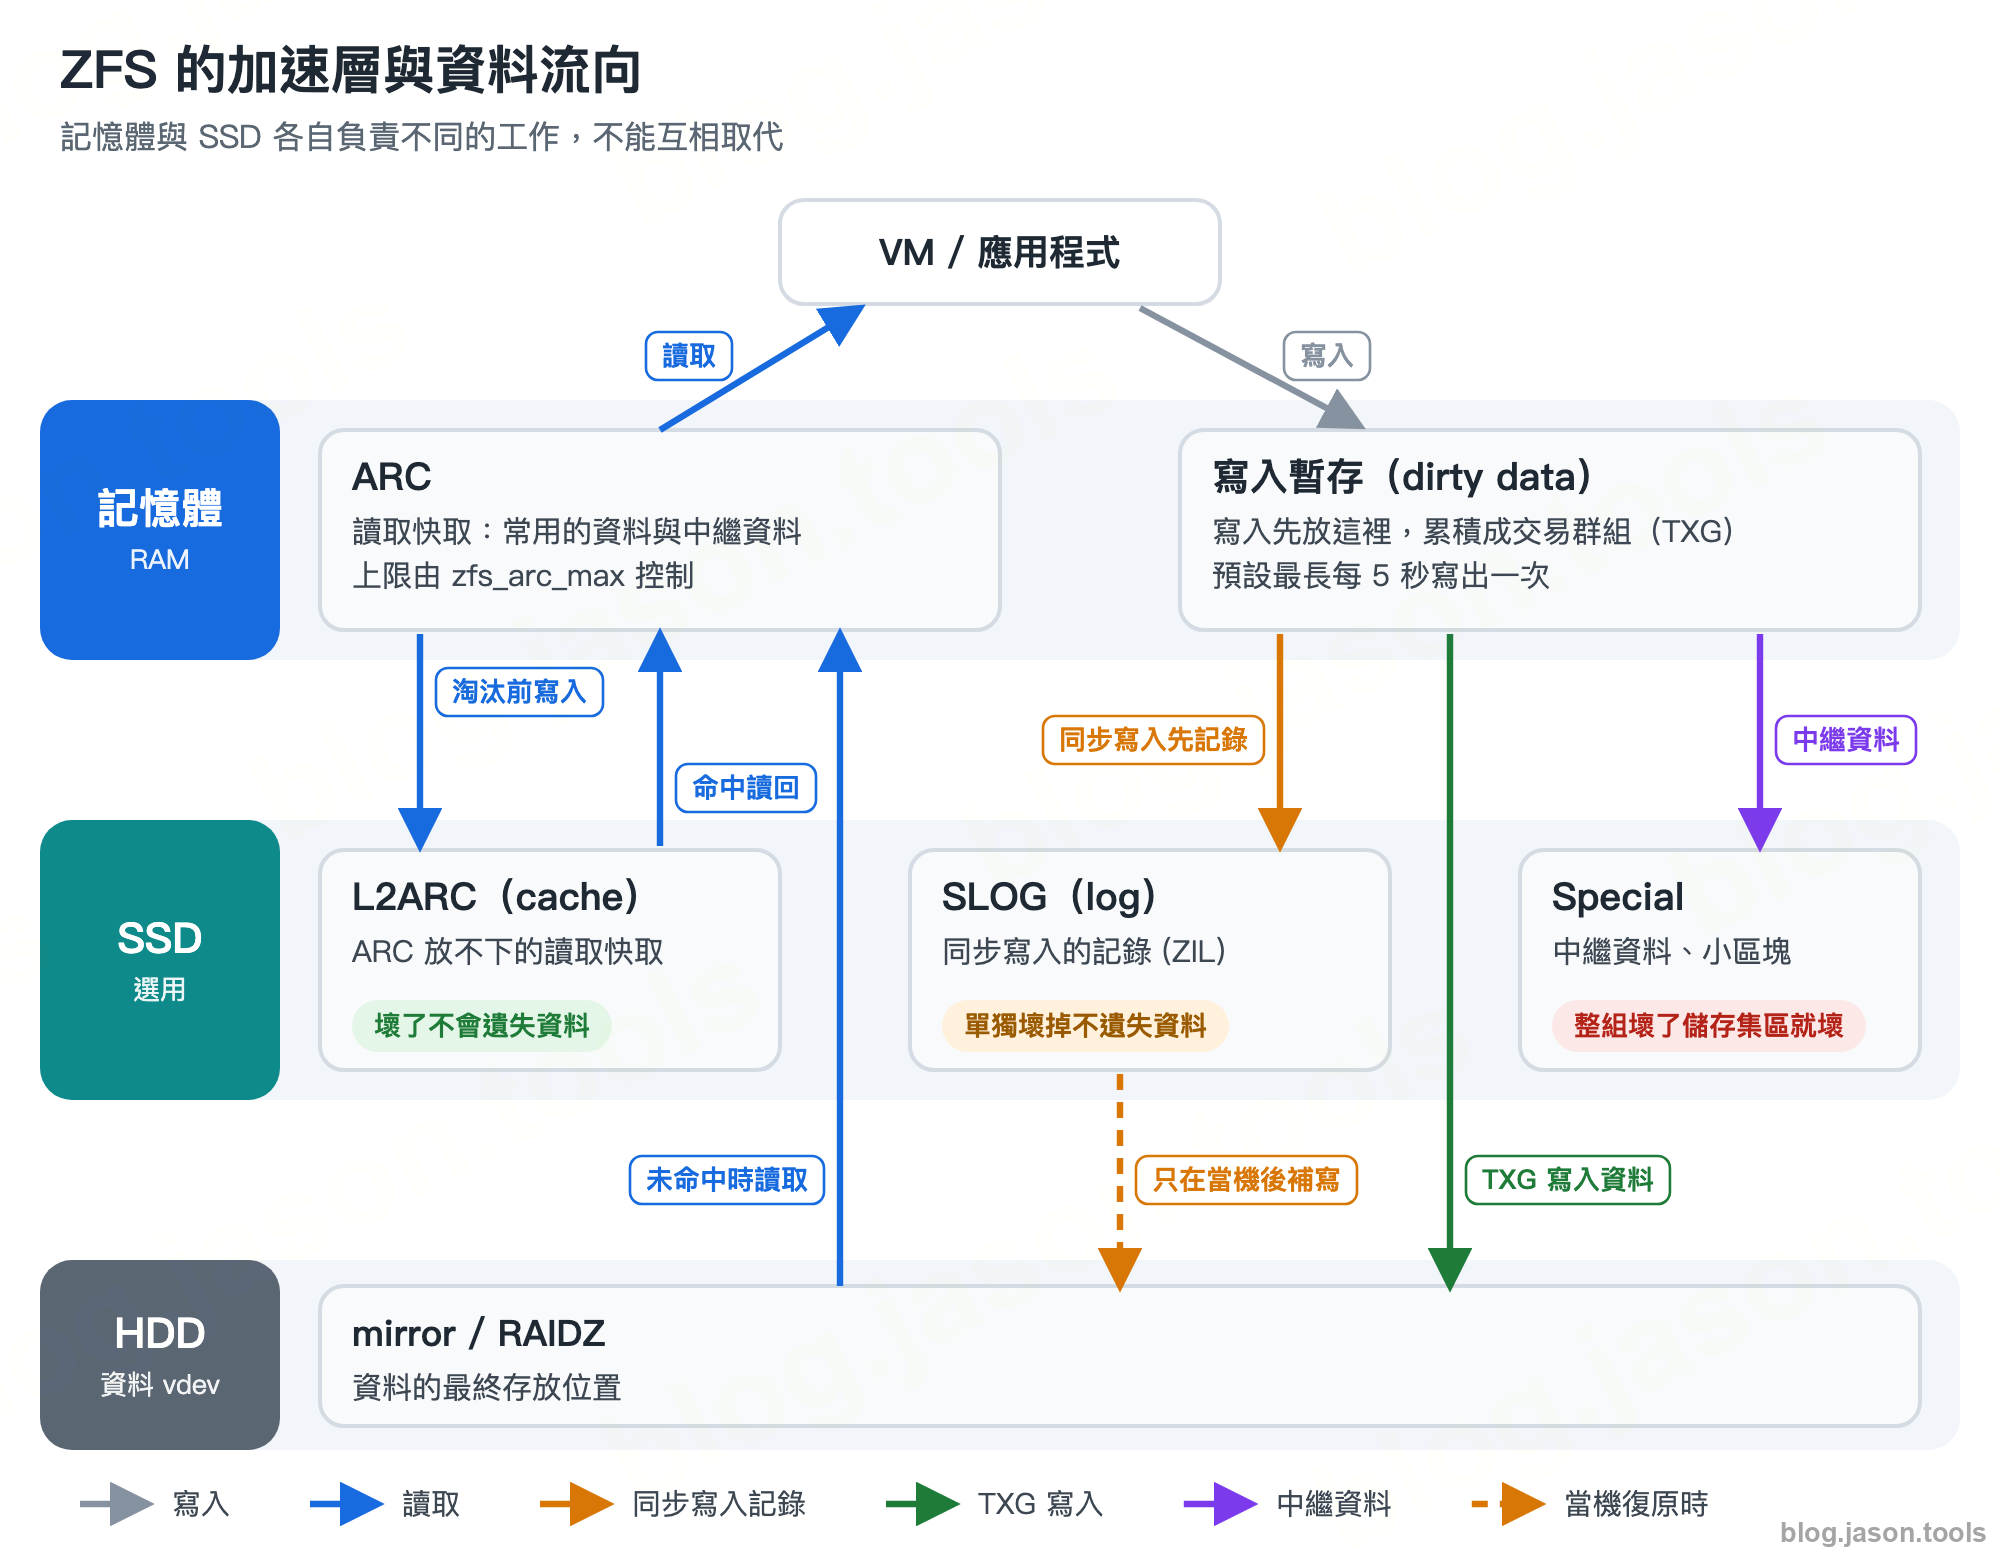
| 角色 | 放什麼 | 對誰有幫助 | 壞掉的影響 |
|---|---|---|---|
| ARC(記憶體) | 常用的資料與中繼資料 | 所有讀取 | 快取內容,重新開機後重新累積 |
| L2ARC(cache) | ARC 放不下的讀取快取 | 重複讀取、資料大致固定的工作負載 | 無,改讀 HDD |
| SLOG(log) | 同步寫入的暫存記錄 | 資料庫、NFS、VM 這類常呼叫 fsync 的寫入 | 單獨壞掉不遺失資料,改用儲存集區內的 ZIL;壞掉又遇到當機,才可能遺失還沒寫進 HDD 的同步寫入 |
| special | 中繼資料、間接區塊,可選小區塊 | 檔案數量多的工作負載,例如 PBS、檔案伺服器 | 整組 special 都無法讀取時,整個儲存集區無法使用 |
這裡的 vdev(虛擬裝置)是 ZFS 組成儲存集區的單位,可以是單顆磁碟,或一組 mirror、RAIDZ、dRAID;中繼資料(metadata)是記錄檔案名稱、目錄結構、資料區塊位置的資料。
ARC 記憶體上限
查看目前狀態
ZFS 的讀取快取 ARC(Adaptive Replacement Cache)放在記憶體裡,PVE 主機上記憶體「被吃掉」大多是它。先看目前的數值:
grep -E '^(c|c_min|c_max|size) ' /proc/spl/kstat/zfs/arcstats
arc_summary -s arc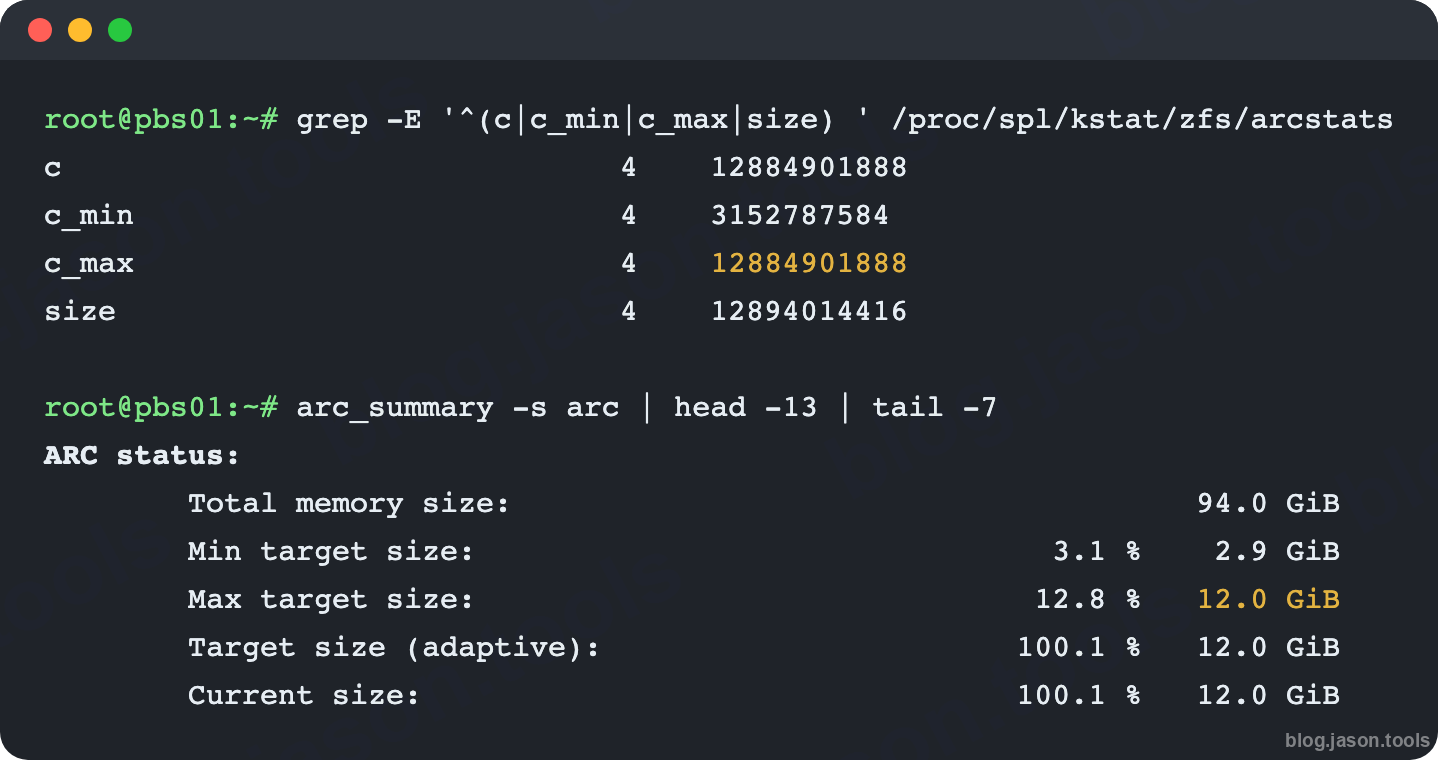
c_max、c_min是上限與下限c是目標大小,ARC 會依記憶體壓力自動調整,不是目前用量size才是實際使用量- 第二欄的
4是資料型別,單位都是 bytes
上面這台 PBS 有 94 GiB 記憶體、上限設 12 GiB;c_min 2.9 GiB 正好是記憶體的 1/32。size 略超過 c_max 是正常的,ARC 會在背景回收。
PVE 安裝後的預設值
用 PVE 安裝光碟安裝(8.1 版起),ARC 上限預設是實體記憶體的 10%,最多 16 GiB。安裝程式會把這個值寫進 /etc/modprobe.d/zfs.conf,選 ZFS 安裝時,也可以在硬碟的進階選項(Options)裡自己改 ARC max size。
依 pve-installer 原始碼,這個檔案不論根檔案系統選 ZFS 還是 ext4、xfs 都會寫入,之後才另外建立的 ZFS 儲存集區一樣受這個上限限制。換算成實際數字:
| 實體記憶體 | PVE 安裝後的 ARC 上限 |
|---|---|
| 16 GiB | 約 1.6 GiB |
| 32 GiB | 約 3.2 GiB |
| 64 GiB | 約 6.4 GiB |
| 128 GiB | 約 12.8 GiB |
| 160 GiB 以上 | 16 GiB(上限封頂) |
這是「最多用到多少」,不是開機就佔掉:ARC 會隨著讀取慢慢長大到上限,系統記憶體不足時也會釋放。要確認自己的主機用哪個值:
grep -E '^c_max ' /proc/spl/kstat/zfs/arcstats   # 實際生效的上限
grep -r zfs_arc_max /etc/modprobe.d/ # 設定來源以下兩種情況安裝程式不會替你設上限,除非後來自己設過,否則就是 OpenZFS 本身的預設值:
- PVE 8.1 以前安裝、之後一路升級上來的主機
- 先裝 Debian 再加裝 PVE 套件的主機
| OpenZFS 版本 | ARC 預設上限 | 128 GiB 主機的例子 |
|---|---|---|
| 2.3 起 | 「記憶體 − 1 GiB」與「記憶體 × 5/8」取較大者 | 約 127 GiB |
| 2.3 以前 | 記憶體的 50% | 64 GiB |
也就是說,同樣是 PVE 9,用安裝光碟裝的主機 ARC 最多 12.8 GiB,升級上來的舊主機卻可能吃到 127 GiB,VM 能用的記憶體差很多。這類主機建議自己設上限,PVE 文件的經驗值是至少 2 GiB,再加上每 TiB 儲存空間 1 GiB。
下限 c_min 預設是「記憶體的 1/32」與 32 MiB 取較大者,兩種情況相同。
永久設定
在 /etc/modprobe.d/zfs.conf 加入(或修改)這一行,以 16 GiB 為例:
options zfs zfs_arc_max=17179869184根檔案系統在 ZFS 上時(PVE 用 ZFS 安裝就是),要更新 initramfs 再重新開機才會生效,因為 ZFS 模組在 initramfs 階段就載入了:
update-initramfs -u -k all
reboot
-k all 會更新所有已安裝核心的 initramfs,用 proxmox-boot-tool 開機的主機也會一併同步到 EFI 開機分割區。
立即調整(重新開機後還原)
不必背數字表,讓 shell 直接計算:
echo $((16 * 1024**3)) > /sys/module/zfs/parameters/zfs_arc_max
cat /sys/module/zfs/parameters/zfs_arc_max
調降上限後 ARC 是逐步釋放,不會瞬間掉下來。也不要為了釋放 ARC 而執行 zpool export,這會讓整個儲存集區離線,上面執行中的 VM 會出問題。
有一個容易踩到的限制:執行中修改時,zfs_arc_max 必須大於目前的 c_min,否則新的上限會被忽略。記憶體很大的主機(例如 512 GiB,c_min 就是 16 GiB)要把上限設得很小時,要先降 zfs_arc_min:
echo $((8 * 1024**3 - 1)) > /sys/module/zfs/parameters/zfs_arc_min
echo $((8 * 1024**3))     > /sys/module/zfs/parameters/zfs_arc_max
寫在 zfs.conf 就沒有這個問題:模組載入時如果上限小於預設下限,ZFS 會自動把下限降成上限的一半(arc.c 的 arc_init())。
有些主機是用開機腳本執行 echo 來設上限,也能用,差別是開機到腳本執行之前 ARC 仍用預設上限。建議改回設定檔的做法,從模組載入就生效。
命中率
arc_summary -s archits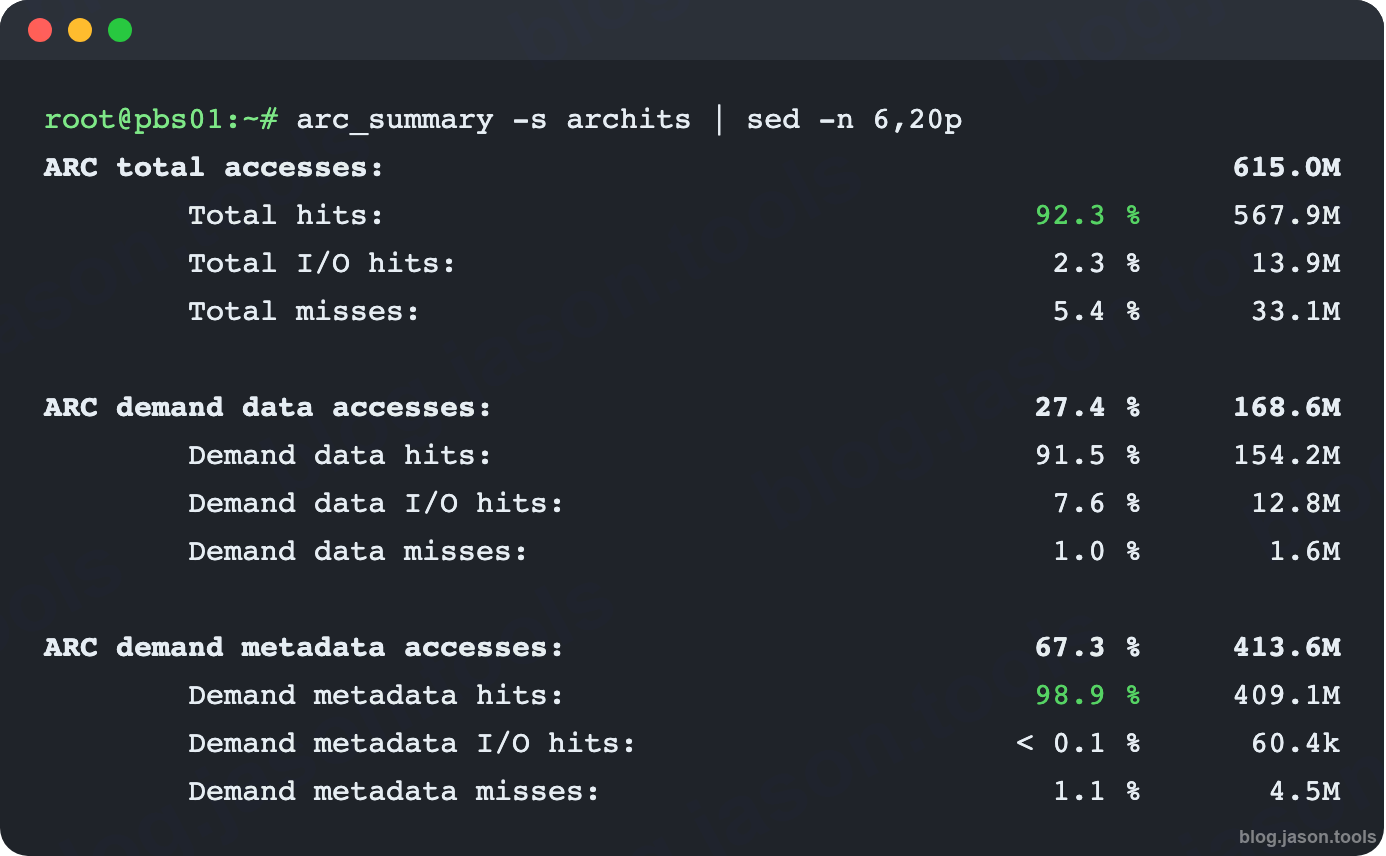
這裡的數字是開機以來的累計值,適合當作參考線索,要判斷 ARC 夠不夠,最好在主要工作負載期間觀察變化,並把資料與中繼資料的命中率分開看。命中率偏低又有記憶體可用時,加大 ARC 通常比加 L2ARC 有效。輸出中的 MFU(最常使用)與 MRU(最近使用)是 ARC 的兩種清單,可以看出命中多半來自哪一種。
OpenZFS 2.4 起這兩個工具改名為 zarcsummary、zarcstat,PVE 的套件仍保留 arc_summary、arcstat 連結,兩種名稱都能用。以下每 10 秒顯示一次、共 10 次:
arcstat 10 10sync 屬性與 SLOG
同步寫入才會經過 ZIL
ZIL(ZFS Intent Log)是 ZFS 存放「同步寫入」的暫存記錄,沒有另外指定時放在儲存集區的資料磁碟上;SLOG(Separate Log)就是把 ZIL 移到另一個較快的裝置。
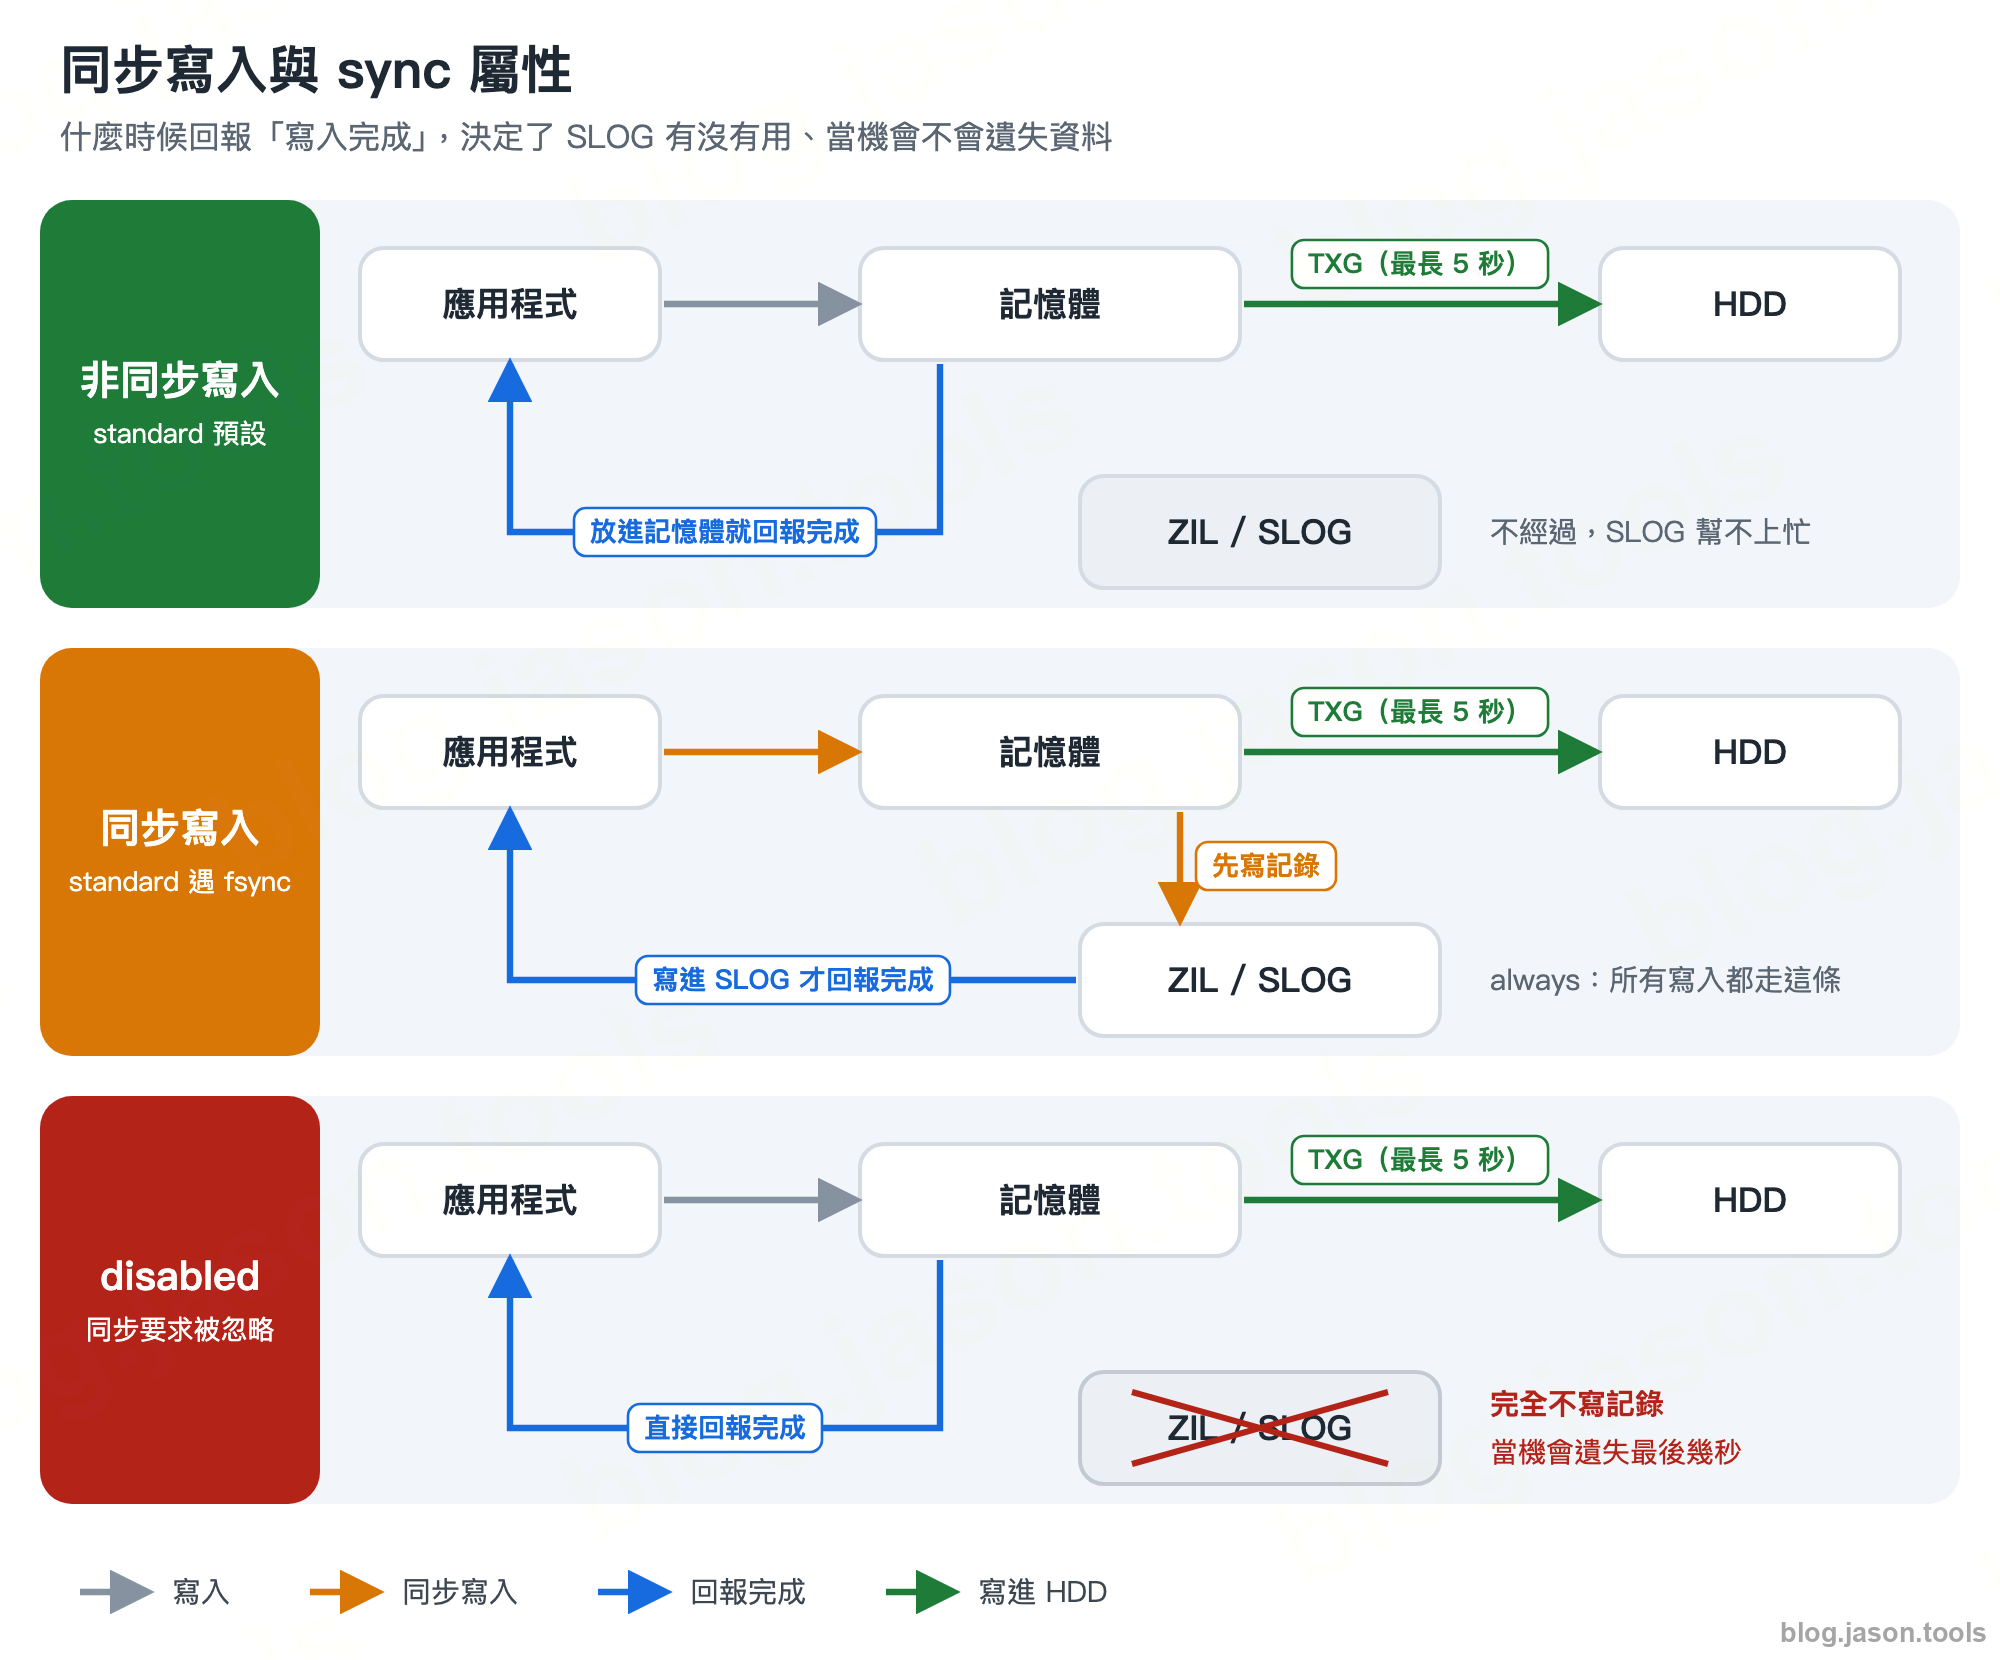
所以 SLOG 有沒有效,關鍵在於寫入是不是同步寫入,這由應用程式的要求與資料集的 sync 屬性共同決定:
| sync | 行為 |
|---|---|
standard(預設) | 應用程式要求同步(fsync、O_SYNC)時才寫 ZIL,有 SLOG 就寫 SLOG |
always | 所有寫入都當同步寫入,全部經過 ZIL/SLOG |
disabled | 同步要求直接回報完成,完全不寫 ZIL |
在 sync=standard 下,應用程式沒有要求同步的寫入本來就不經過 ZIL,所以 SLOG 只對同步寫入的延遲與 IOPS 有幫助,對一般非同步寫入和讀取都沒有幫助。另外,資料集設成 logbias=throughput 時,同步寫入的資料本體會直接寫進儲存集區,SLOG 只放指向這些區塊的小筆記錄,幾乎幫不上忙。
sync=disabled 看起來最快,代價是資料只在記憶體裡,要等交易群組(TXG)寫入磁碟。TXG 預設每 5 秒觸發一次(zfs_txg_timeout),磁碟忙碌時實際寫完的時間可能更長。這段時間內當機,VM 以為已經寫進去的資料會不見,資料庫與 VM 內的檔案系統可能因此不一致。
pveperf <掛接路徑> 的 FSYNCS/SECOND 只能當粗略參考:我看了 pve-manager 9.2 的 pveperf,它每次建立一個小檔案、寫入 4 KB 後就呼叫 fsync,但這時資料多半還在 Perl 的輸出緩衝區,fsync 主要提交的是建立檔案的動作。要比較加 SLOG 前後的差異,請用後面「效能測試的方法」的 fio。
SLOG 要多大
SLOG 只保存「還沒寫進儲存集區的同步寫入」,資料寫進去後就能覆蓋,不是越大越好。
它的用量受兩個參數限制:還沒寫入磁碟的資料量 zfs_dirty_data_max(預設記憶體的 1/10,且不超過記憶體 1/4 與 4 GiB 中較小者),以及 ZIL 記錄量的上限 zfs_wrlog_data_max(預設是前者的兩倍),接近上限時寫入會被節流。ZIL 只會累積幾個 TXG 的量,以預設值來說,16 GB 左右是合理的起始規劃,PVE 文件的說法是最大約為實體記憶體的一半;同步寫入量特別大的環境再依實際用量調整。
加入與移除 log、cache
Linux 上請一律用 /dev/disk/by-id/ 的路徑,裝置重新排序也不會認錯。
zpool add <pool> log   /dev/disk/by-id/<ssd1>
zpool add <pool> cache /dev/disk/by-id/<ssd2>

# 移除時用 zpool status 顯示的名稱
zpool remove <pool> <裝置名稱>
log 可以做 mirror,cache 不行:
# 兩顆 SSD 做成 mirror 的 log
zpool add <pool> log mirror /dev/disk/by-id/<ssd1> /dev/disk/by-id/<ssd2>

# 這樣寫是兩顆各自當 cache(容量相加),不是 mirror
zpool add <pool> cache /dev/disk/by-id/<ssd3> /dev/disk/by-id/<ssd4>
cache 裝置沒有 mirror 或 RAID 模式,讀取出錯時 ZFS 會直接改讀儲存集區,不會遺失資料。移除 mirror 的 log 時,要用 zpool status 裡的名稱(例如 mirror-1)。
一顆 NVMe 切兩區
手上只有一顆 NVMe 時,可以切成兩個分割區,log 依上面的規劃給 16 GiB,其餘給 cache(PVE 文件也是這個做法):
DISK=/dev/disk/by-id/nvme-<型號>_<序號>

# mklabel 會重建分割表、破壞原本的配置,先確認這顆磁碟沒有在使用
readlink -f $DISK                         # 實際的裝置名稱,核對型號與序號
lsblk -o NAME,SIZE,FSTYPE,LABEL,MOUNTPOINTS $(readlink -f $DISK)
wipefs -n $(readlink -f $DISK)*           # 整顆磁碟與每個分割區
zpool status -LP                          # 已匯入的儲存集區用到哪些裝置
zpool import                              # 只列出可匯入的儲存集區,不會匯入

parted -s $DISK mklabel gpt
parted -s -a optimal $DISK mkpart log 1MiB 16GiB
parted -s -a optimal $DISK mkpart cache 16GiB 100%

zpool add <pool> log ${DISK}-part1 cache ${DISK}-part2
這樣做的取捨是 log 只有一份。主機正常運作時 SLOG 壞掉,還沒寫進 HDD 的資料其實仍在記憶體裡,會照常隨下一個 TXG 寫入,所以不會遺失資料;當下的同步寫入會改成等 TXG 寫完才回報,可能出現短暫停頓,之後 ZFS 改用儲存集區內的 ZIL。SLOG 上的記錄只有在當機後重新匯入時才會讀回補寫,因此只有「SLOG 壞掉」又遇上「主機當機」,才可能遺失還沒寫進 HDD 的同步寫入。遺失的範圍是當時還沒完成 TXG 的那些交易,系統忙碌時可能超過 5 秒;而且少了 log 裝置,儲存集區可能要用 zpool import -m 才能匯入,這個選項會直接捨棄 log 上的記錄。用 mirror 就是為了連這種情況也避開。另外,log 與 cache 共用同一顆 SSD,L2ARC 的寫入也會和同步寫入搶同一個控制器,對延遲要求高的環境最好分開。當 SLOG 的 SSD 要有斷電保護(PLP),沒有 PLP 的消費級 SSD 每次同步寫入都要等資料真正寫進快閃記憶體,同步寫入效能往往很差。
L2ARC 也不是加了就好:它的索引要佔用 ARC 的記憶體,記憶體不夠時先加記憶體比加 L2ARC 有效。OpenZFS 2.0 起 L2ARC 重新開機後會保留內容(l2arc_rebuild_enabled=1),不必重新累積。
查看使用情形
zpool iostat -v -y <pool> 1 100    # 每秒一次,共 100 次
zpool iostat -vp -y <pool> 1       # -p 顯示精確數值
不加 -y 時,第一筆是開機以來的平均值,不是當下的狀況。預設的數字是 K/M/G 換算過的,加 -p 改成精確值:容量是 bytes,頻寬是每秒 bytes,operations 是每秒次數。
Special device
放什麼、對誰有效
special 是 ZFS 0.8 起的配置類別,依 zpoolconcepts(7),預設存放:
- 所有中繼資料
- 使用者資料的間接區塊(記錄資料區塊位置的區塊)
- 去重複表(DDT,開了 dedup 才有)
- 沒有 SLOG 時的 ZIL
- 選用:
special_small_blocks門檻以下的小資料區塊
對「檔案數量多、常建立、刪除、列目錄」的工作負載最有效,例如 PBS 的 chunk store(數百萬個 chunk 檔)、檔案伺服器、郵件。單純放 VM 磁碟(zvol)的儲存集區,效果要看 volblocksize、快照數量與存取模式,通常不如大量小檔案明顯,最好先實測再決定。
實際案例:64 顆 HDD 的 PBS
我處理過一個案子:客戶的 PBS 用 64 顆 7200 轉 near-line HDD 組成備份用的 datastore,容量足夠,但備份、還原、驗證與 GC 的效能都不夠用。
PBS 把備份切成大量 chunk 檔案存放,每次備份、驗證、GC 都要大量查詢與更新檔案的中繼資料,這些小量隨機讀寫正好是 HDD 最弱的地方。所以我替這個儲存集區加入三顆 SSD,做成三向 mirror 的 special device,把中繼資料移到 SSD 上。
為什麼是三顆?因為 special 的 mirror 只要整組壞光,整個儲存集區的資料就讀不出來,64 顆 HDD 上的備份會一起報廢。我的原則是:
- 至少兩顆做 mirror,任何情況都不用單顆
- 資料量大、重建時間長的儲存集區用三顆:換 SSD 時有一顆在重建,另外兩顆仍然互為備援,不會出現「只剩一顆撐著」的空窗
這台是正式環境,原本沒有 special,後來才加上去,所以沒有辦法停機做加入前後的效能測試。但上線一年後,瀏覽 PBS 的備份清單、要還原時開啟備份內容,速度都有非常明顯的提升。
一年的時間也有關係:special 只對新寫入的區塊有效,這段期間新的備份不斷寫入,舊備份依保留規則清除後,不再被引用的 chunk 也會被 GC 刪掉,落在 SSD 上的中繼資料比例會逐漸提高。PBS 會去重複,內容沒變的舊 chunk 仍會沿用,所以不是全部。
下面的步驟就是當時的做法。
加入 special
# 建立儲存集區時一起加(PBS 文件範例)
zpool create -o ashift=12 <pool> mirror <hdd1> <hdd2> special mirror <ssd1> <ssd2>

# 現有的儲存集區加入,三顆做三向 mirror(上面案例的做法)
zpool add <pool> special mirror /dev/disk/by-id/<ssd1> /dev/disk/by-id/<ssd2> /dev/disk/by-id/<ssd3>
任何一組 special vdev 的所有 SSD 都壞掉,整個儲存集區就無法使用。它的備援等級要和資料 vdev 相當(PBS 文件:redundancy should match the one of the pool),RAIDZ2 的儲存集區建議配三向 mirror。
- 加入後通常無法取消:儲存集區的資料 vdev 只要有 RAIDZ 或 dRAID,
zpool remove就不能移除 special 這類頂層 vdev(zpool-remove(8));log 與 cache 不受這個限制 - SSD 要資料中心級、有斷電保護,並用不同廠牌或不同批次混搭,避免同時故障
- 不小心加成單顆時,可以用
zpool attach <pool> <現有SSD> <新SSD>把它變成 mirror
special_small_blocks
zfs set special_small_blocks=4K <pool>             # 整個儲存集區(子資料集繼承)
zfs set special_small_blocks=0  <pool>/<dataset>   # 單一資料集不放小區塊
zfs get -r special_small_blocks <pool>這個屬性預設是 0,只放中繼資料。設成 4K 是額外讓「壓縮後 4K 以下」的小資料區塊也寫進 SSD,PBS 文件就是拿 4K 當範例。
有兩點要特別注意:
- 門檻大於或等於資料集的 recordsize 時,所有資料都會寫進 SSD
- OpenZFS 2.4 起這個門檻也套用到 zvol(zfsprops(7):small file or zvol blocks)。新建 zvol 的預設區塊是 16K,門檻設到大於或等於 zvol 的
volblocksize時,之後寫入的 VM 磁碟資料都會優先放進 SSD,設定前先用zfs get volblocksize確認
滿了會怎樣
special 快滿時的行為分成兩個階段:
- 使用率達到 75%(剩餘空間低於 25%)時,小資料區塊就不再寫進 special(
zfs_special_class_metadata_reserve_pct=25),空間留給中繼資料 - special 再也配置不出空間時,中繼資料才會改寫到一般 vdev,碎片化可能讓這件事在名目容量用完之前就發生(zpoolconcepts(7):spill back into the normal class)
資料不會受損,只是那部分又回到 HDD 的速度,所以規劃時以使用率 75% 以下為目標。
舊資料要重寫才會受益
加入 special 之後,只有新寫入的區塊會放到 SSD,ZFS 不會搬既有資料。要讓舊資料受益,就得重寫一次。
做法一是搬到另一個資料集再搬回來。跨資料集的 mv 實際上是「複製再刪除」,所以會重寫;同一個資料集裡的 mv 只是改名,沒有效果。
注意 block cloning:OpenZFS 2.2 起,儲存集區開啟 feature@block_cloning 時,同一個儲存集區內跨資料集的複製可能只複製區塊參照,資料區塊沒有重寫,也不會搬到 special(新建立的檔案與目錄中繼資料仍會寫到 special)。先用 zpool get feature@block_cloning <pool> 確認,顯示 enabled 或 active 時,搬移期間暫時把 zfs_bclone_enabled 設成 0。這是整台主機的模組參數,會影響其他資料集,先記下原值、結束後設回原值。
PBS 的 datastore 先設維護模式,並等正在執行的備份、還原、驗證、同步與 GC 工作結束,再開始搬移:
proxmox-backup-manager datastore update <store> --maintenance-mode offline
screen

# 原資料集的加密與壓縮屬性
zfs get encryption,encryptionroot,compression <datastore 的資料集>

# 暫存資料集建在同一個加密根底下,名稱不能已經存在
zfs list <父資料集>/tempdata && echo "已存在,請換名稱"
zfs create -o mountpoint=/<pool>/tempdata <父資料集>/tempdata
zfs get mountpoint,mounted,encryption,encryptionroot,compression <父資料集>/tempdata

# 有開 block cloning 時才需要,先記下原值
cat /sys/module/zfs/parameters/zfs_bclone_enabled
echo 0 > /sys/module/zfs/parameters/zfs_bclone_enabled

mv /<datastore路徑>/.chunks /<pool>/tempdata/ && \
mv /<pool>/tempdata/.chunks /<datastore路徑>/ && \
chown backup:backup /<datastore路徑>/.chunks && \
echo "搬移完成"

echo <原值> > /sys/module/zfs/parameters/zfs_bclone_enabled只有看到「搬移完成」才繼續。任何一步失敗,資料可能還在暫存資料集裡,維持維護模式、先查原因,不要刪除暫存資料集。
確認 .chunks 完整後,改成唯讀維護模式,在 PBS 上抽查還原;offline 模式連讀取都會擋,無法抽查。驗證(verify)工作要寫入狀態,唯讀模式下不能跑,要等解除維護、並暫停其他排程後再執行:
proxmox-backup-manager datastore update <store> --maintenance-mode read-only

# 還原抽查無誤後,再刪除暫存資料集並解除維護
zfs list -r <父資料集>/tempdata
zfs destroy <父資料集>/tempdata
proxmox-backup-manager datastore update <store> --delete maintenance-mode- 剩餘空間要有一整份資料那麼大(整個
.chunks),跨檔案系統的 mv 會整個複製完才刪除來源 - 暫存資料集的屬性繼承自它的父資料集,原本有加密的資料,暫存資料集要建在同一個加密根底下,不要搬到未加密的資料集
- 資料集有快照時,舊區塊被快照留住,空間多佔一份,舊的中繼資料也還在
- 數 TB 的資料要搬很久,一定要在 screen 或 tmux 裡執行
做法二是 OpenZFS 2.4 新增的 zfs rewrite,原地把檔案區塊重寫到新位置,通常不需要預留一整份空間,但有快照或共用區塊時用量會增加。它重寫的是檔案的資料區塊,目錄等其他中繼資料不一定會跟著搬。這個我還沒實測:
zfs rewrite -r -x /<datastore路徑>/.chunks加上 -P 可以保留區塊原本的時間,增量 send 不會把它當成變更,但需要儲存集區開啟 physical_rewrite 功能,可以只開這一項:zpool set feature@physical_rewrite=enabled <pool>。第一次使用 -P 後這個功能會變成 active,不支援它的舊版 ZFS 就只能唯讀匯入這個儲存集區。
用 zfs send 與 zfs receive 複製一份資料集也會重寫所有區塊。完整步驟是停止存取、完成最後一次同步、核對新資料集的屬性與掛接點,再用 zfs rename 換回原本的名稱,確認服務正常後才刪除舊資料集。
容量估算
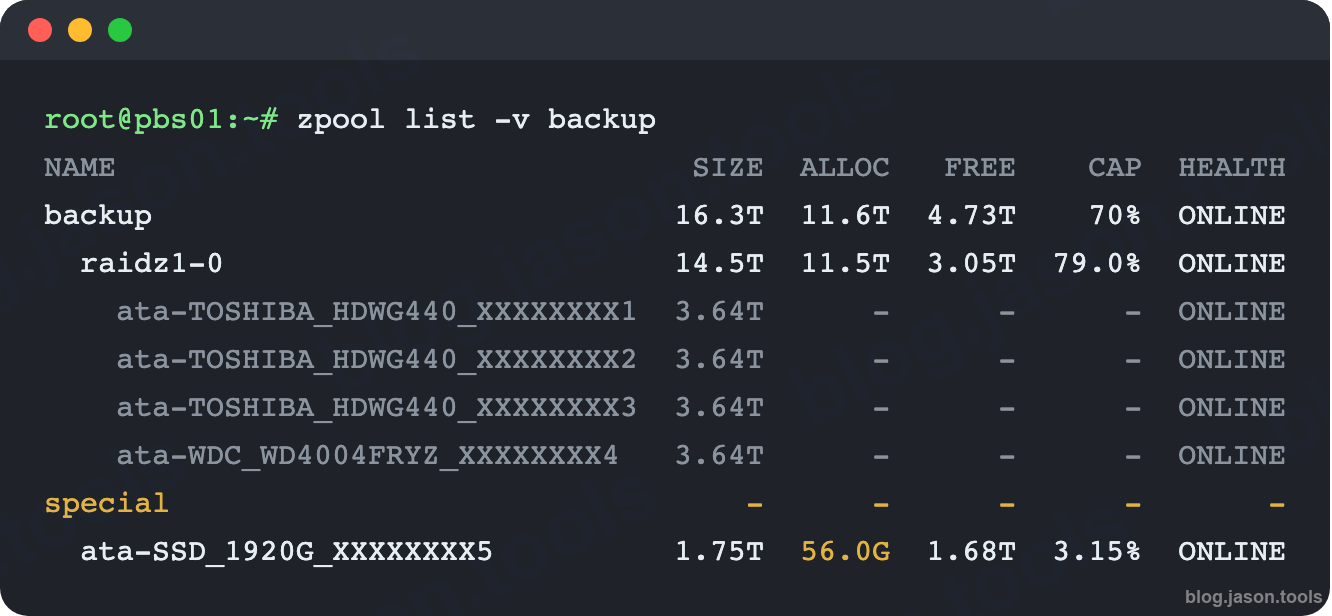
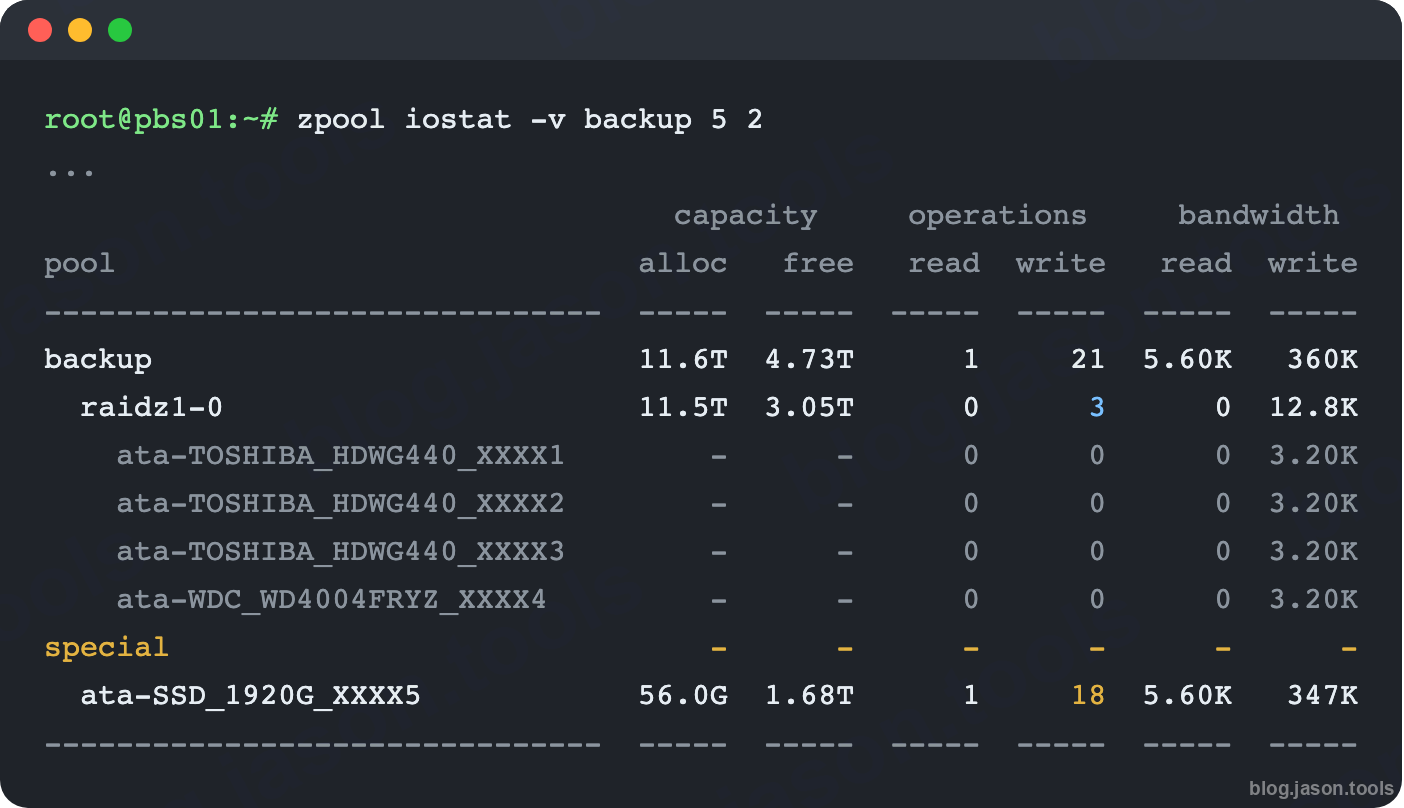
論壇常見的估法是「儲存容量的 2%」(100 TB 配 2 TB),只能當粗略的起始估算,大量小區塊、去重複表或 small blocks 都可能超過。最準的是看實際主機,zpool list -v 裡 special 分類下面那一列(多組時要加總)的 ALLOC 就是目前用量:
這台 PBS 是 4 顆 4 TB 的 RAIDZ1,special_small_blocks=4K,chunk 都已重寫過:儲存集區 ALLOC 11.6 TiB(含 RAIDZ 同位資料),special 只用了 56 GiB,約 0.5%。這是單一主機的觀測值,規劃時還要加上成長與保留空間。同一台在一般備份時段的 zpool iostat -v 取樣(第二筆、5 秒區間),這段期間的寫入大多落在 special,HDD 只有零星寫入:
| 工作負載 | 參考比例(佔儲存集區 ALLOC) |
|---|---|
| PBS chunk store | 約 0.5%(上圖單一主機的觀測值) |
| VM 磁碟(zvol) | 依 volblocksize 與快照而定,通常較低 |
| 檔案數量極多(郵件、原始碼、記錄檔) | 1% 到數 % |
| 加上 small blocks | 再加上門檻以下的資料量 |
要估 small blocks 會佔多少,可以先統計各大小區間的檔案數量:
find /<路徑> -type f -printf '%s\n' | awk '
  { s = 1024; while (s < $1) s *= 2; n[s]++ }
  END { for (k in n) print k, n[k] }' | sort -n
ZFS 的判斷單位是區塊而不是檔案:大於 recordsize 的檔案會切成多個區塊,門檻看的也是壓縮後的大小,所以這只是估算。更精確可以用 zdb -Lbbbs <pool> 看區塊大小分布,但大型儲存集區要跑好幾個小時、讀取量也很大,請選離峰時段。
效能測試的方法
很多人習慣用下面這種 dd 指令測寫入速度,在 ZFS 上常會測出每秒好幾 GB 的數字,但那不是磁碟的實際速度:
dd if=/dev/zero of=/<pool>/test.out bs=1M count=10/dev/zero寫的是全零,開了壓縮幾乎不佔空間,測到的是壓縮速度- 資料量太小,整筆留在記憶體就回報完成,測到的是記憶體速度
- 資料集是
sync=standard時,這個 dd 是非同步寫入,不經過 SLOG,有沒有加 log 結果都一樣 - 沒有加
conv=fdatasync,結束時資料不一定寫進磁碟
改用 fio(apt install fio),它預設寫入隨機內容,比全零資料更接近實際。下面加上 --refill_buffers 讓每次寫入都換新內容,進一步排除壓縮的影響:
# 同步小區塊隨機寫入:看 SLOG 有沒有幫助
zfs create -o mountpoint=/mnt/fiotest <pool>/fiotest
zfs get mounted,sync,logbias,compression,recordsize,special_small_blocks <pool>/fiotest

fio --name=syncwrite --directory=/mnt/fiotest --size=4G \
    --rw=randwrite --bs=4k --ioengine=psync --sync=1 --refill_buffers \
    --numjobs=4 --runtime=60 --time_based --group_reporting

rm -f /mnt/fiotest/*

# 大區塊循序寫入:寫入量要明顯大於記憶體(以 94 GiB 記憶體為例約 150 GiB)
fio --name=seqwrite --directory=/mnt/fiotest --size=150G \
    --rw=write --bs=1M --ioengine=psync --end_fsync=1 --refill_buffers --group_reporting

zfs destroy <pool>/fiotest- 用獨立的測試資料集,先記下
sync、logbias等屬性;繼承到sync=disabled時,--sync=1也不會走 ZIL - 沒有指定
--filename時,fio 會依 job 名稱與編號產生不同檔名,4 個 job 各寫各的檔案(同步測試共約 16 GiB);--directory只是指定目錄 - 循序測試的
--size依主機記憶體與剩餘空間調整,可以用zfs get compressratio <pool>/fiotest確認實際沒有被壓縮 - 同步寫入看的是延遲與 IOPS;循序吞吐量要寫到超過記憶體、數字穩定下來,並以結尾的 fsync 完成為準
- 每個條件(無 log、有 log、
sync=always)各跑幾次再比較 - 讀取測試的第二次以後通常比較快,因為資料已經在 ARC 裡
結論
回到開頭的問題,我目前的做法是:記憶體先給 ARC 設好合理的上限,PVE 8.1 以前裝的主機尤其要檢查;有大量同步寫入(資料庫、NFS)才加 SLOG,並選有斷電保護的 SSD;HDD 上放大量小檔案(例如 PBS)時,special 的效果最明顯,但它和儲存集區同生共死,一定要 mirror。
L2ARC 則放在最後考慮,記憶體還能加的話,加記憶體通常比較划算。
ZFS 隨版本變化很快,幾年前的文章,指令名稱、預設值都可能已經不同,套用之前先對照目前版本的 man page。
參考資料
- PVE 管理指南:ZFS on Linux
https://pve.proxmox.com/pve-docs/chapter-sysadmin.html#chapter_zfs - PBS 管理指南:ZFS special device
https://pbs.proxmox.com/docs/sysadmin.html#local-zfs-special-device - OpenZFS 模組參數 zfs(4)
https://openzfs.github.io/openzfs-docs/man/v2.4/4/zfs.4.html - OpenZFS zpoolconcepts(7)
https://openzfs.github.io/openzfs-docs/man/v2.4/7/zpoolconcepts.7.html - OpenZFS zfsprops(7)
https://openzfs.github.io/openzfs-docs/man/v2.4/7/zfsprops.7.html - OpenZFS zfs-rewrite(8)
https://openzfs.github.io/openzfs-docs/man/v2.4/8/zfs-rewrite.8.html - Proxmox 論壇:Need help for ZFS special device
https://forum.proxmox.com/threads/need-help-for-zfs-special-device.100260/