現在品質很好的 AI 語音合成不少,但多半是線上服務,要念的文字得先上傳到業者的伺服器。公開的文章無妨,換成內部簽呈、會議記錄或尚未公開的報告,就等於把內部文件交給外部,有資料外洩的疑慮。
速度也是問題。有些工具只能把整篇文字做成語音檔,要等全部合成完才聽得到,無法即時朗讀;有些雖然可以朗讀,但合成速度跟不上說話的速度,念完一句要停下來等下一句。
拿來念中文時,還常常一開口就是大陸念法:「垃圾」念成ㄌㄚ ㄐㄧ,「星期」的「期」念成一聲,「企業」的「企」念成三聲。聽得懂,但不像台灣的說法。
jt-live-whisper 是我開發的全地端 AI 語音工具箱,v2.27.0 起加入「文字轉語音:台灣華語朗讀」,可以把文字念出來,或直接轉成 MP3、WAV 語音檔。念法以台灣日常說法為準,合成在自己的 GPU 伺服器、Apple Silicon Mac,或有 NVIDIA 顯示卡的 Windows 電腦(v2.32.0 起,Beta)上進行,文字不會送到雲端,也不使用作業系統內建的語音。朗讀時邊合成邊播放,第一段合成好就開始念,不必等整篇做完;在 NVIDIA DGX Spark 上,GPU 空閒時合成一段約花這段音訊長度 0.9 倍的時間,念的速度跟得上。
上一篇介紹的線上會議英中雙向口譯,念中文給我聽用的也是這套朗讀。
兩種用法
文字轉語音是選用安裝的元件:GPU 伺服器在安裝或檢查時會詢問要不要裝(預設「否」,裝完約佔 11 GB),Apple Silicon Mac 本機則在安裝時詢問(預設「是」,約 4 GB)。升級到 v2.27.0 之後也要重新啟動 WebUI。v2.32.0 起,有 NVIDIA 顯示卡的 Windows 電腦也可以選用安裝本機合成(Beta):在安裝資料夾執行 .\install.ps1 -LocalTTS,約佔 20 GB;完整安裝時偵測到 NVIDIA 顯示卡也會詢問(預設「否」)。
裝好後,WebUI 的「輸入來源」多了兩個選項:
- 文字內容朗讀
一邊念一邊顯示字幕。 - 文字轉語音檔
不播放,直接存成 MP3 或 WAV。
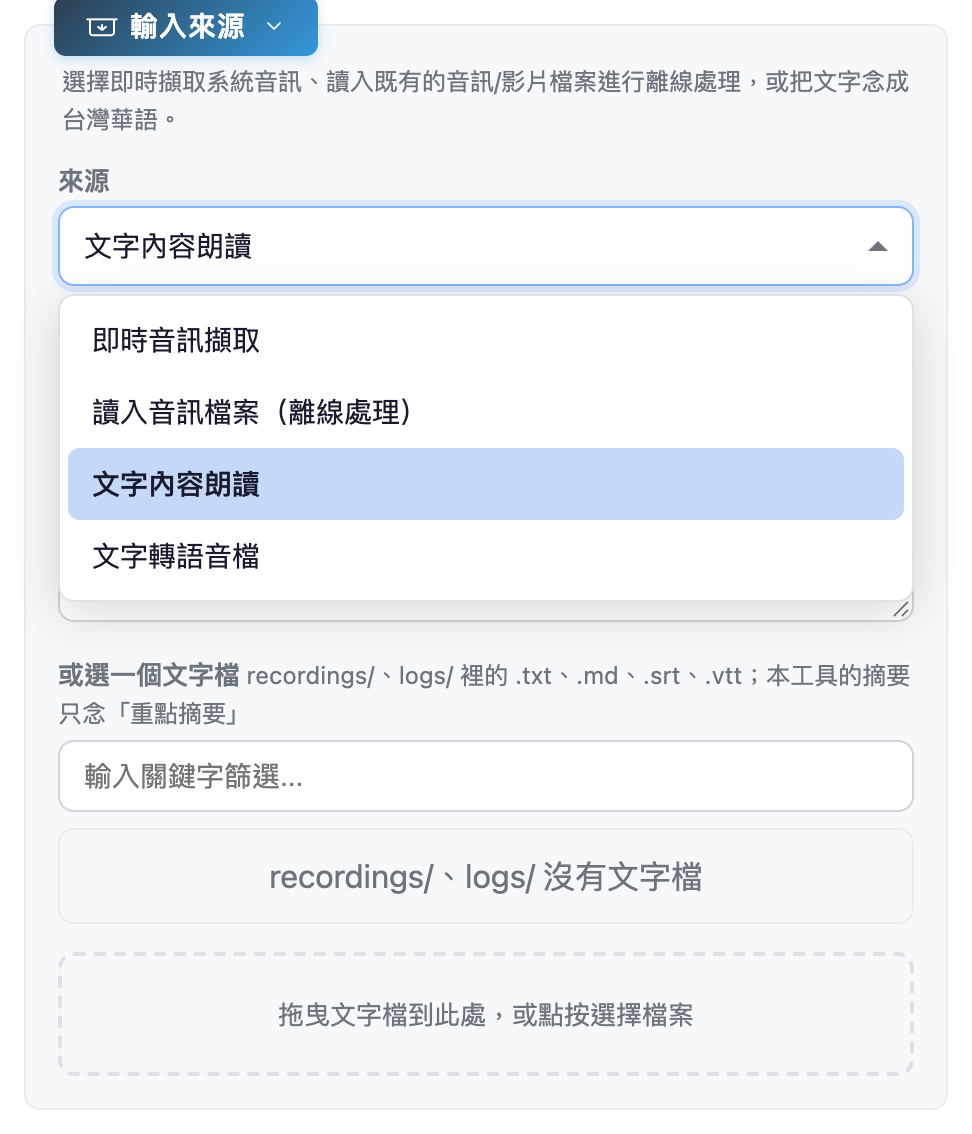
要念的文字可以直接貼上,也可以從執行 WebUI 那台主機的 recordings/、logs/ 資料夾選 .txt、.md、.srt、.vtt 檔,或把文字檔拖進來上傳,一次最多 100,000 字。字幕檔的時間軸、條列符號、網址參數不會念出來;jt-live-whisper 自己產生的會議摘要,只念「重點摘要」那一段。
播放與存檔
播放裝置可以選執行 WebUI 那台主機的喇叭或耳機,也可以選「瀏覽器」。選瀏覽器時,聲音在開著網頁的那台電腦播放,所以 jt-live-whisper 裝在沒有喇叭的伺服器或容器上也能用。用瀏覽器播放時,朗讀中請勿重新整理或關閉那個分頁,沒有分頁在播放時,約 90 秒後就會停止朗讀;只需要音訊檔的話,用「文字轉語音檔」比較合適。
勾選「同時存成音訊檔」的話,念完會在執行 WebUI 那台主機的 recordings/ 留下一份 MP3 或 WAV,從其他電腦使用時,可以用結束卡片上的連結下載。v2.32.0 起,朗讀途中程式當掉、被強制結束或斷電時,下一次開始朗讀會把已經存下的段落收成 recordings/朗讀_日期_時間_未完成.mp3,並說明存到第幾段。
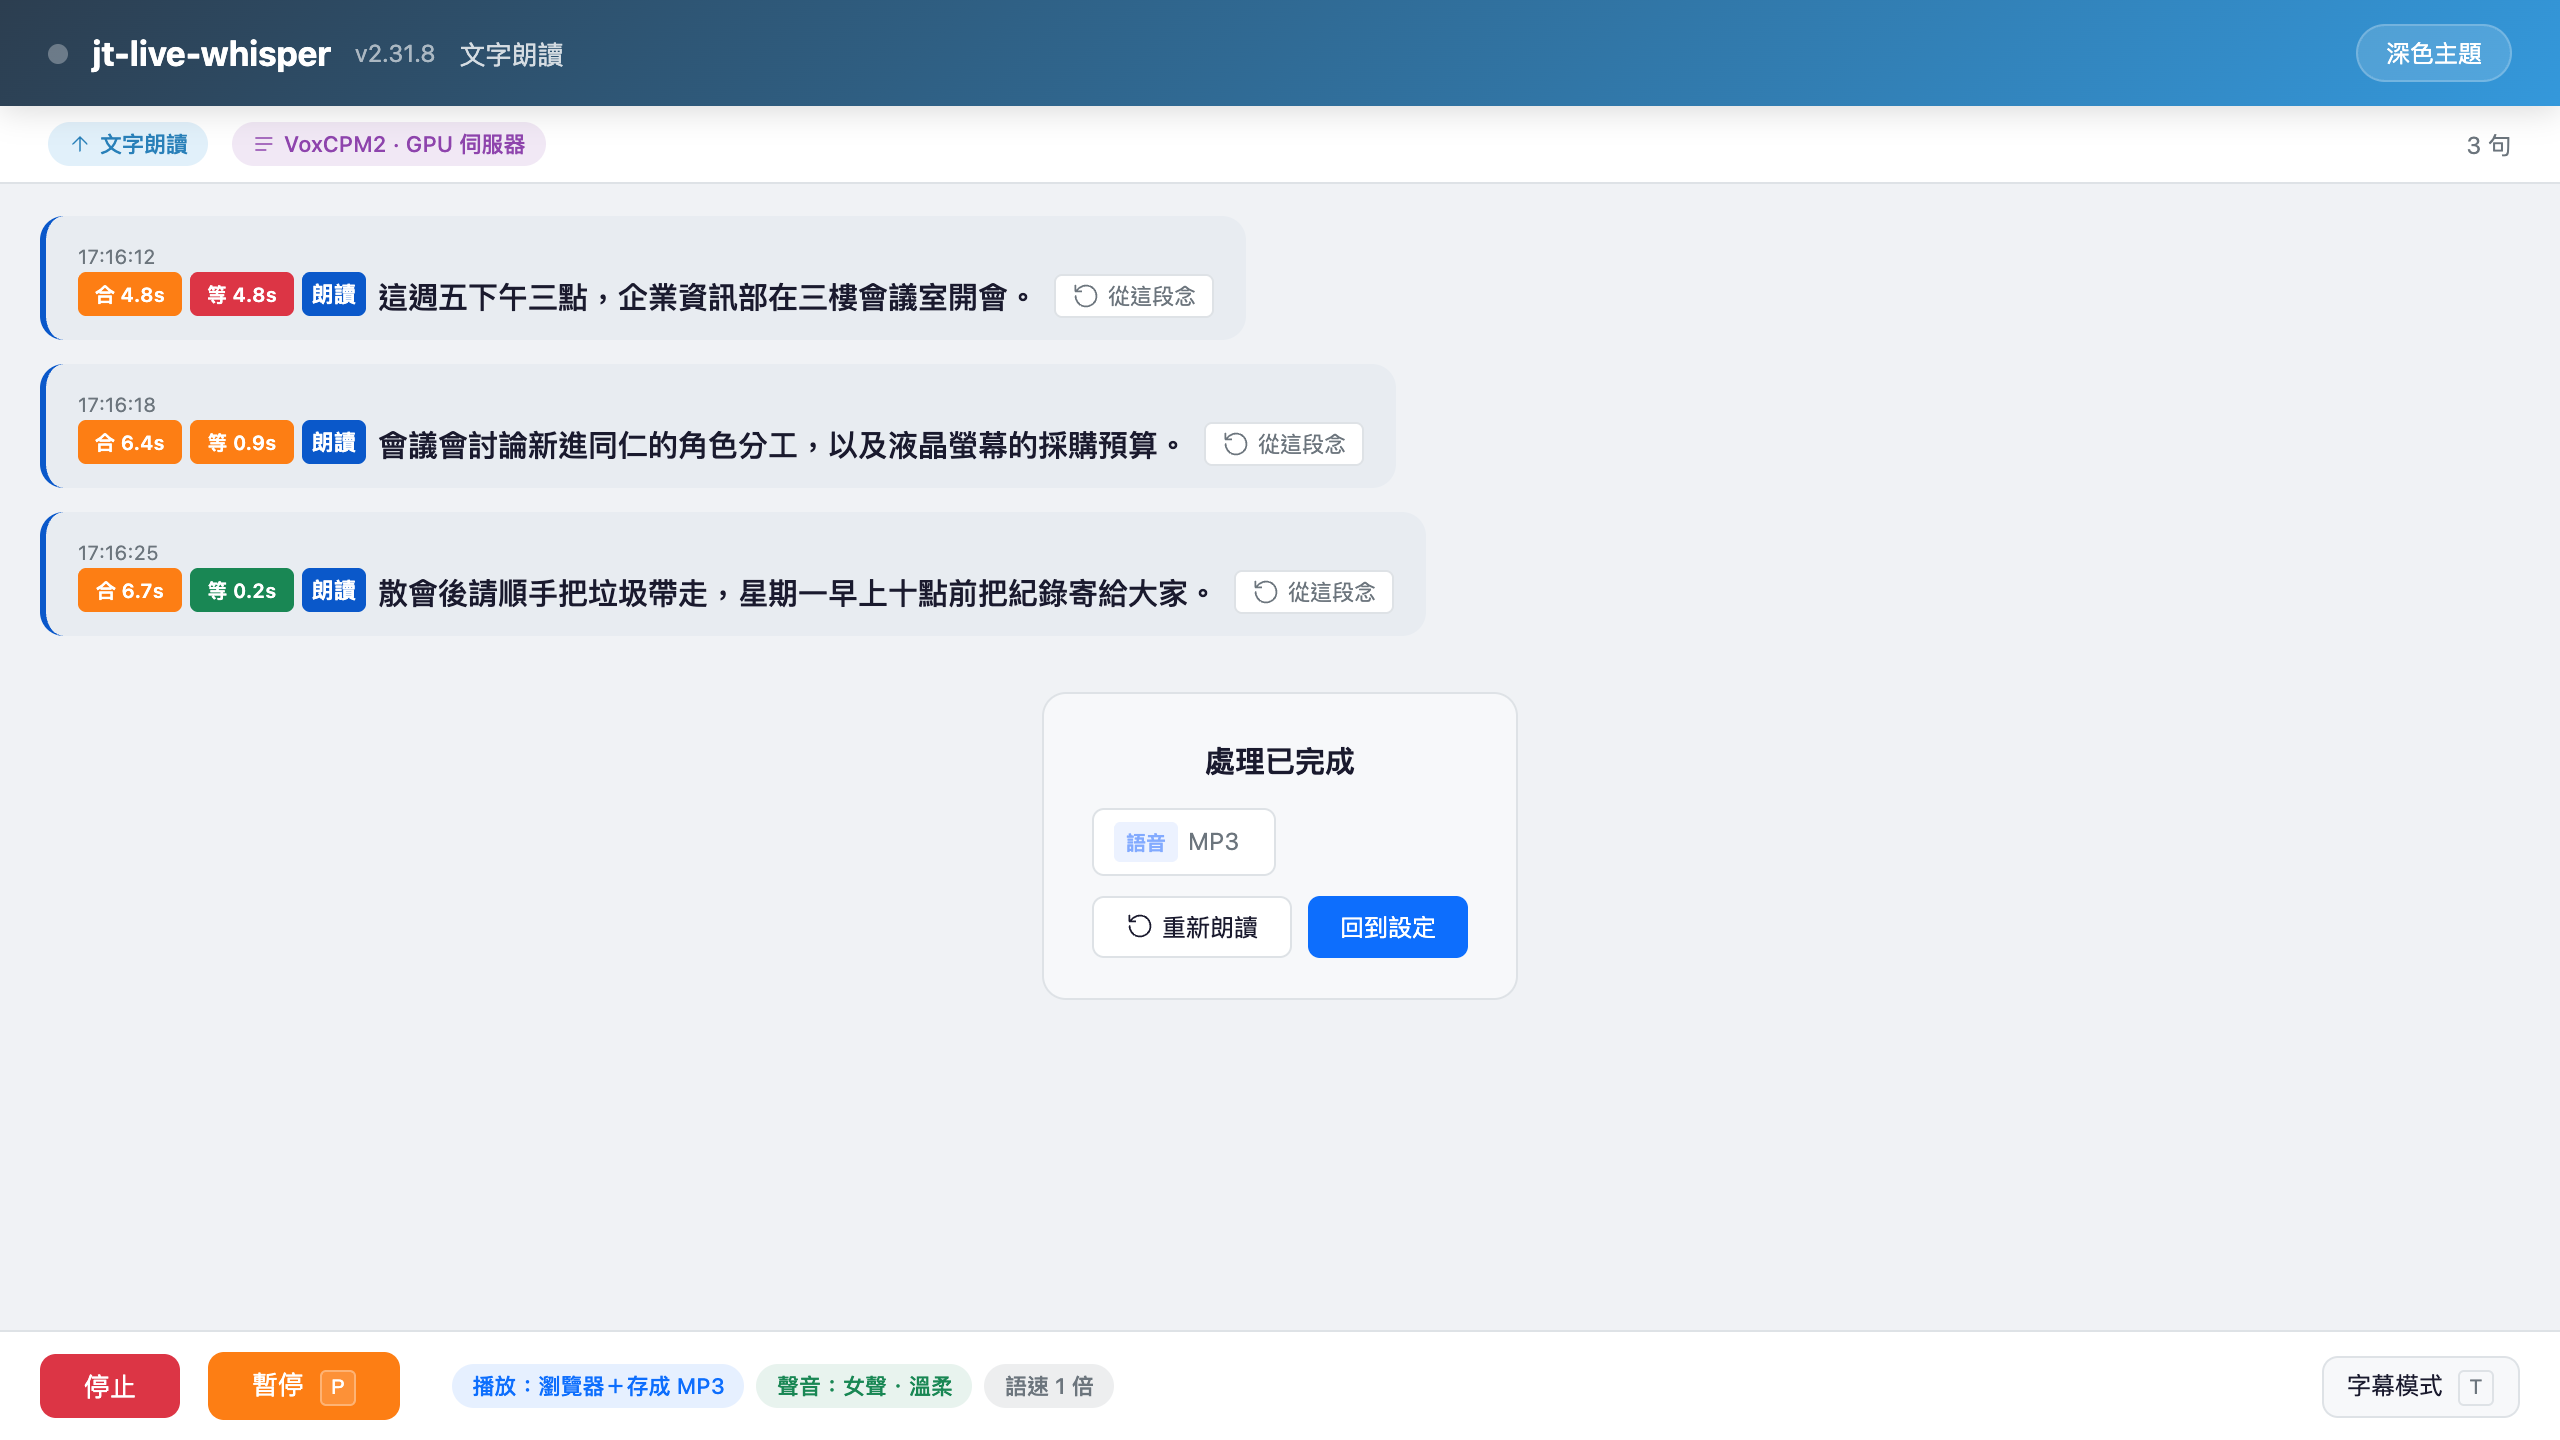
按「開始」後,每一段開始念的時候才顯示那一段字幕。
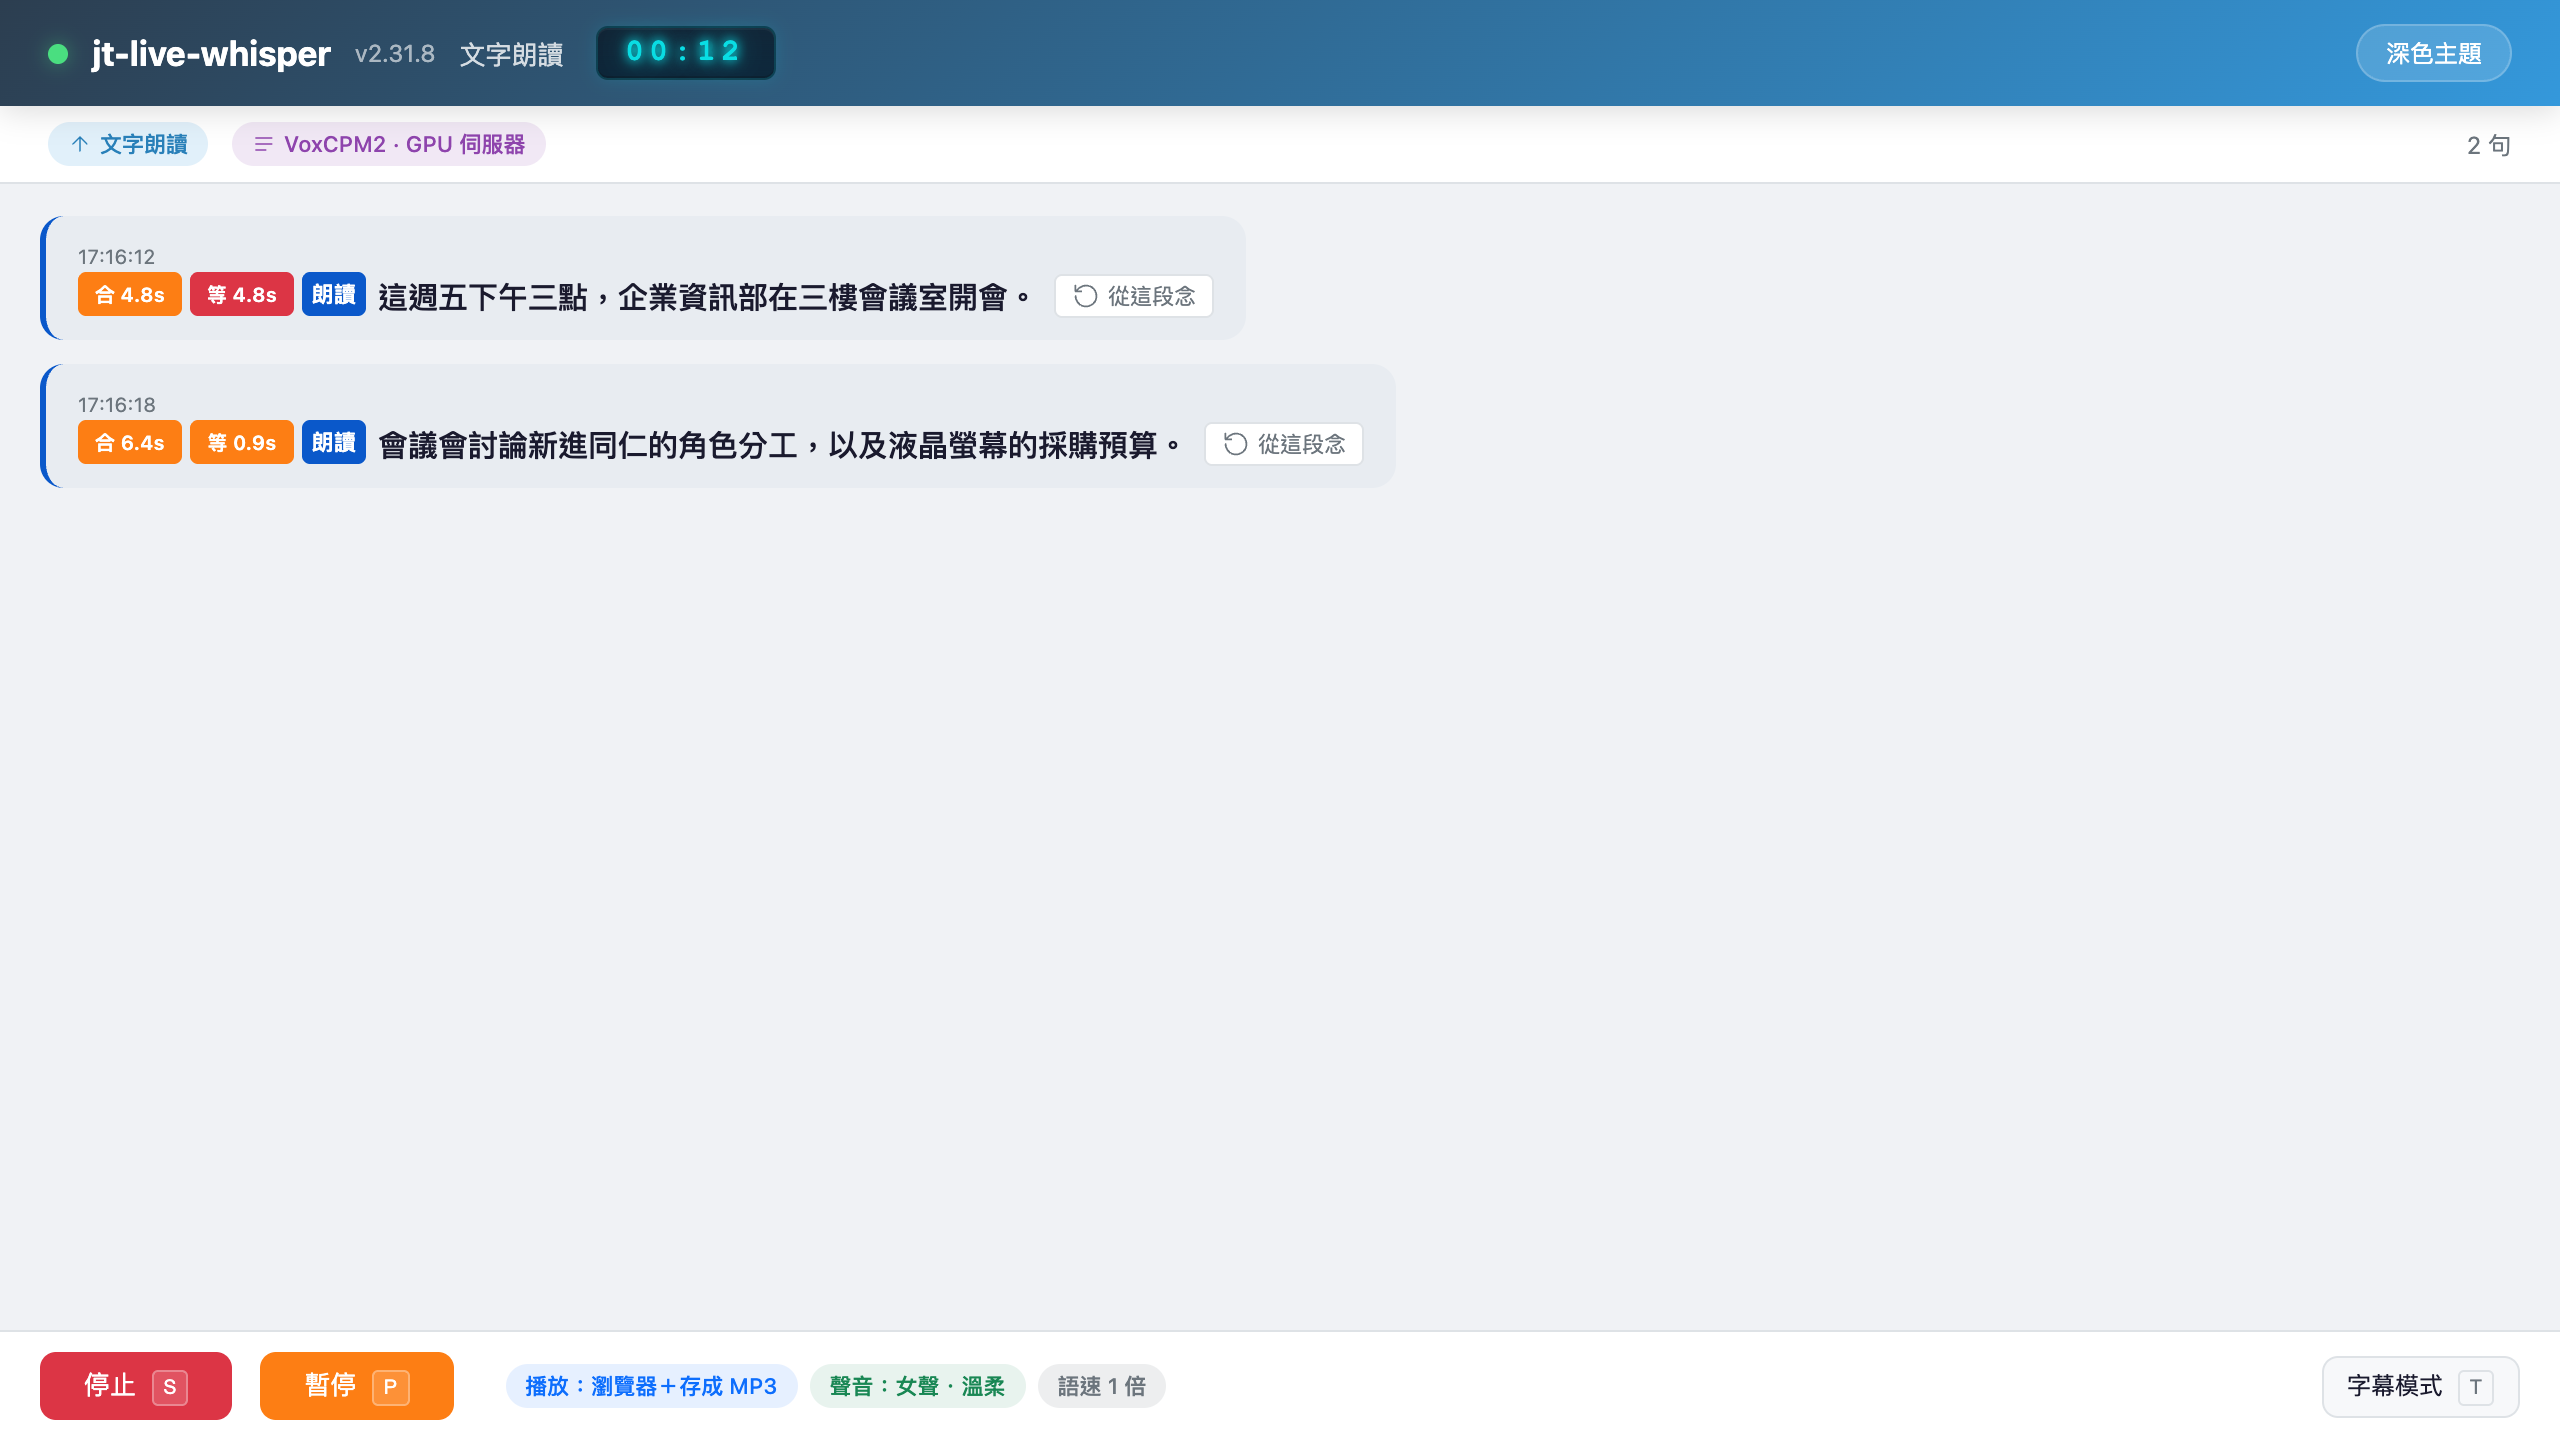
每段字幕前有兩個時間:「合」是這段合成花的秒數,比這段音訊本身短時顯示綠色;「等」是播放時等合成的秒數,第一段代表按下開始後多久出聲。這張截圖拍攝時 GPU 伺服器同時在跑其他工作,所以合成比平常慢。
播放中可以暫停或停止,停止時已經合成的部分照樣存檔。每段字幕後面的「從這段念」會從那一段念到最後;念完後結束卡片上有音訊檔的下載連結,也可以按「重新朗讀」用同樣的文字與設定再念一次。
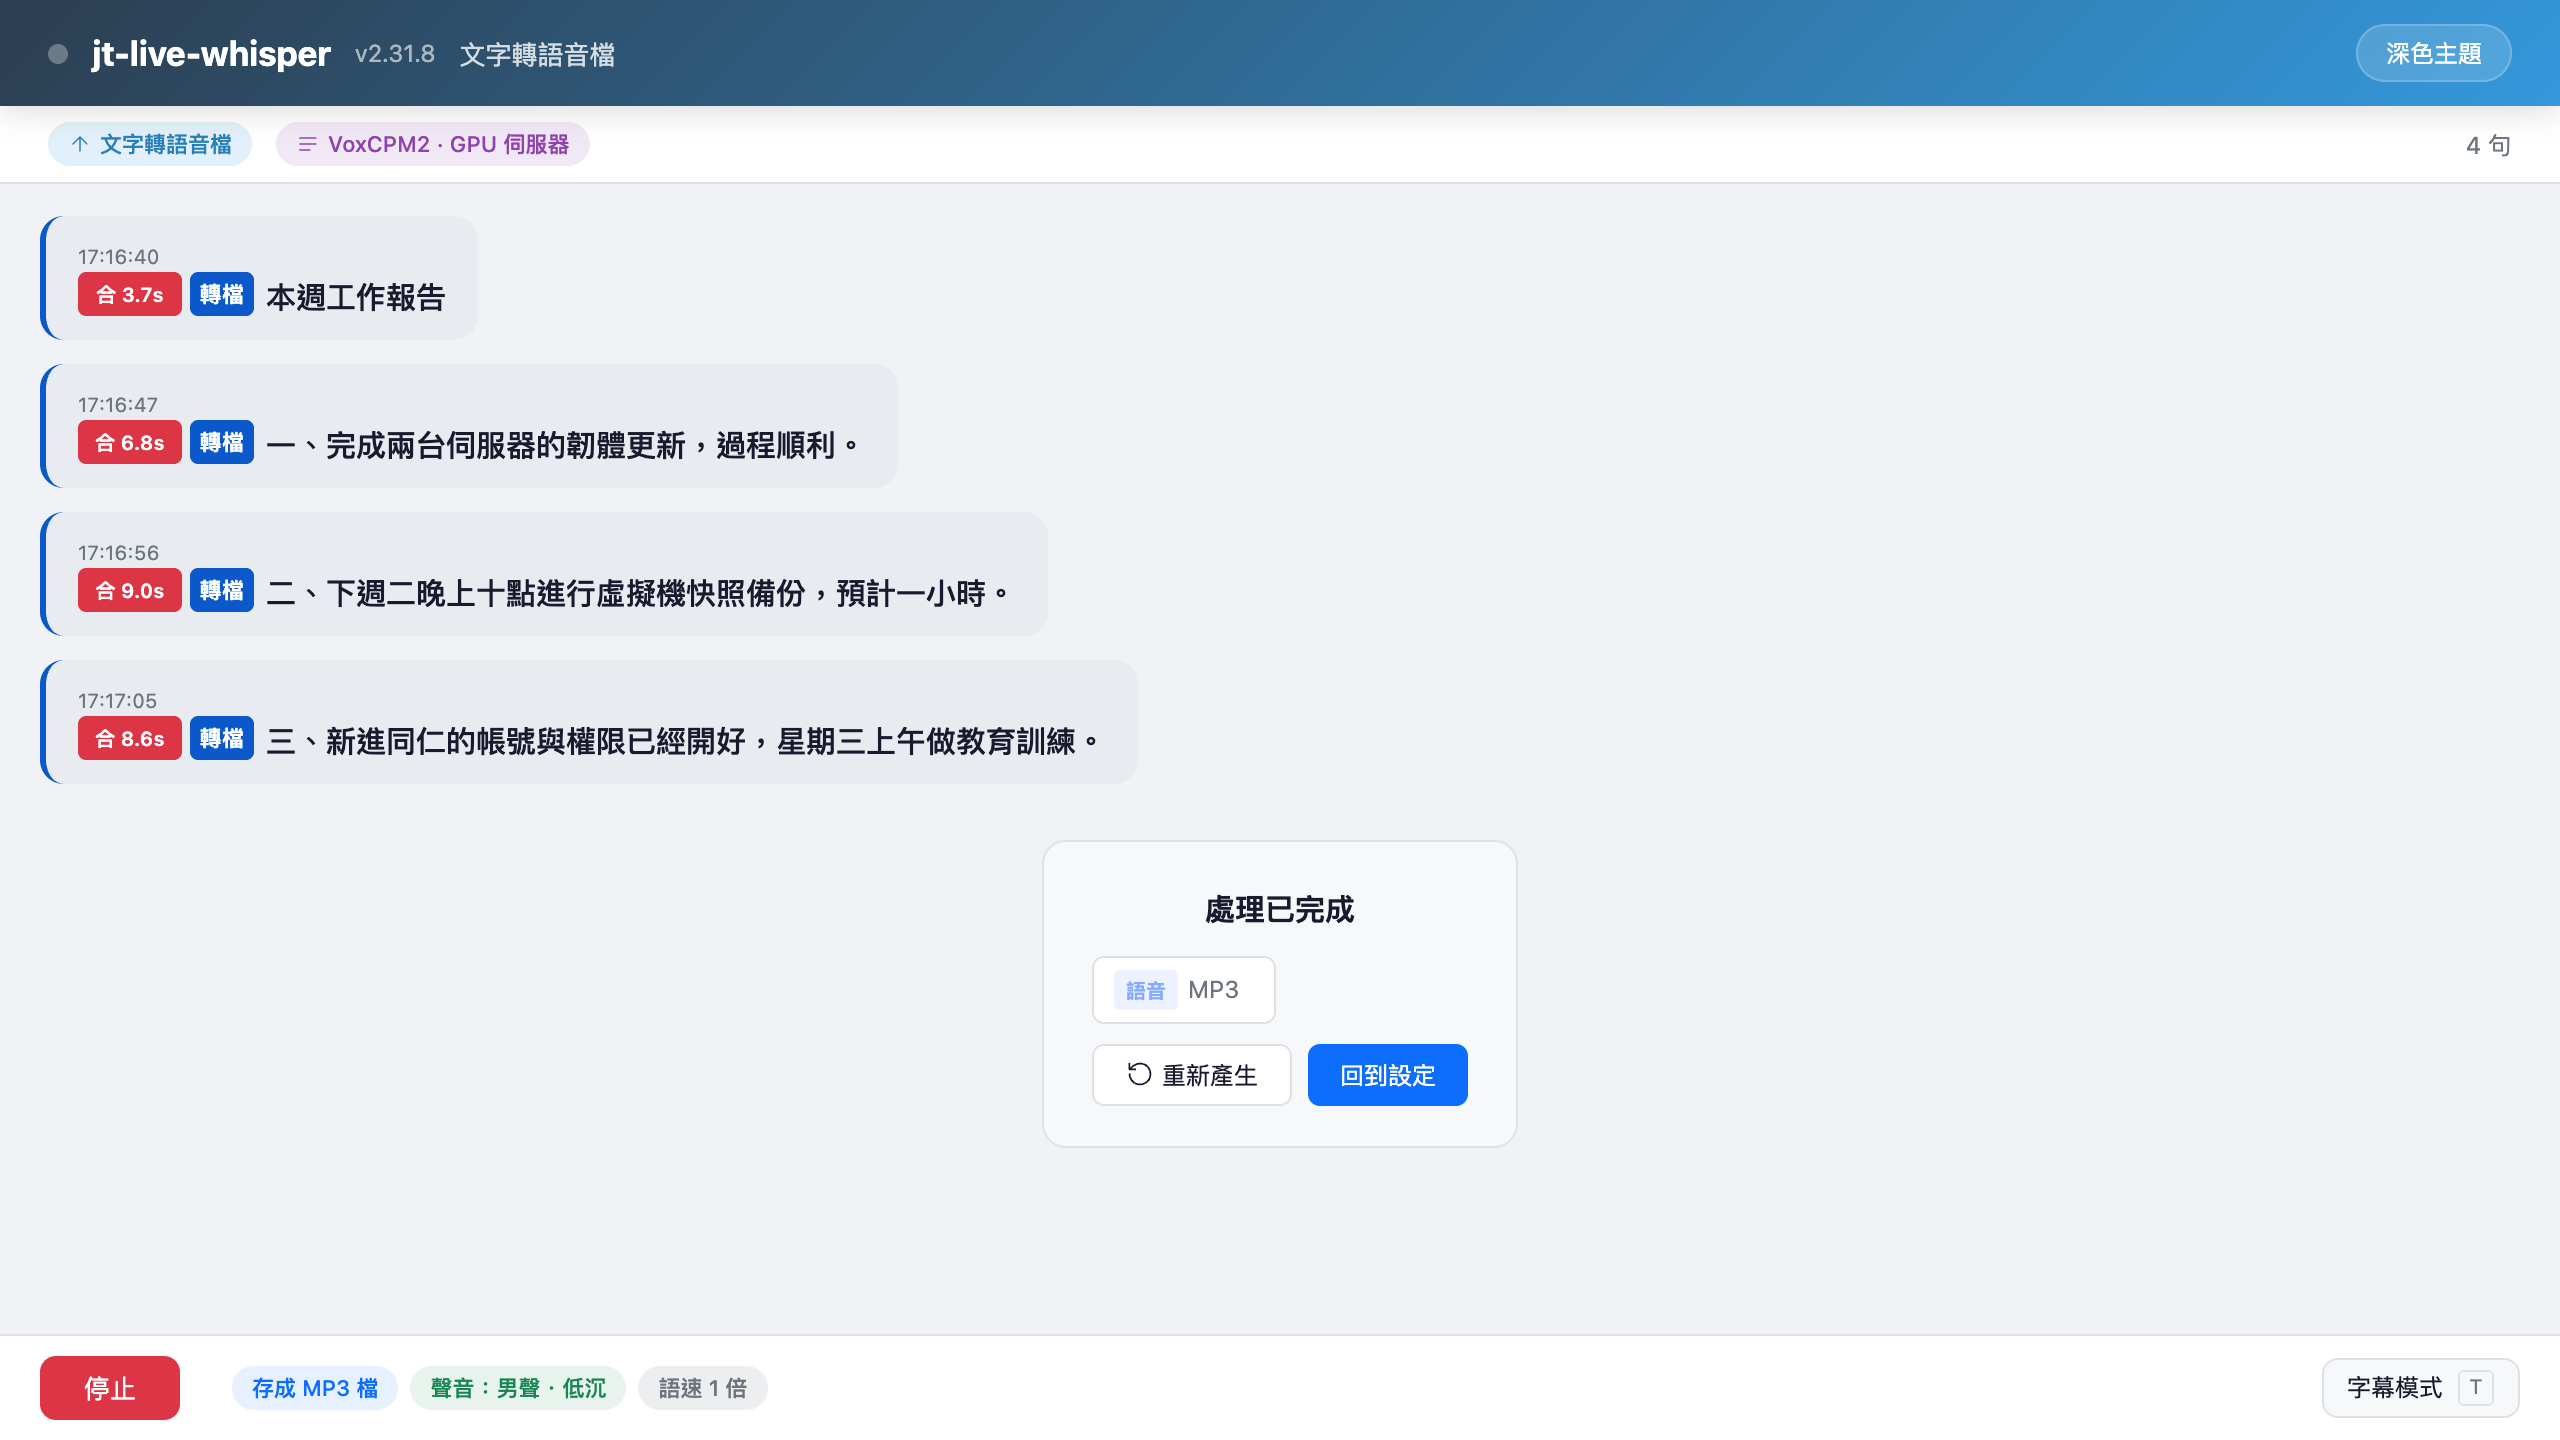
「文字轉語音檔」的畫面相同,只是不播放,按鈕變成「重新產生」。
合成模型與設定
預設的合成模型是 OpenBMB 的 VoxCPM2(Apache-2.0)。選它是為了速度:專案在 NVIDIA DGX Spark 的實測,合成時間約是音訊長度的 0.9 倍,在 Mac M5(32 GB)本機約 1.1 倍,兩種機器都能邊合成邊播放。但它主要學的是大陸念法,台灣念法要由 jt-live-whisper 補上,做法在下一節。
另外可以選用聯發科的 BreezyVoice(Apache-2.0),它以台灣華語訓練,口音比較道地,但專案實測的合成時間約是音訊長度的 1.2~2.5 倍,不適合即時朗讀,而且只能在 GPU 伺服器上用,適合不趕時間、要轉成語音檔的時候。
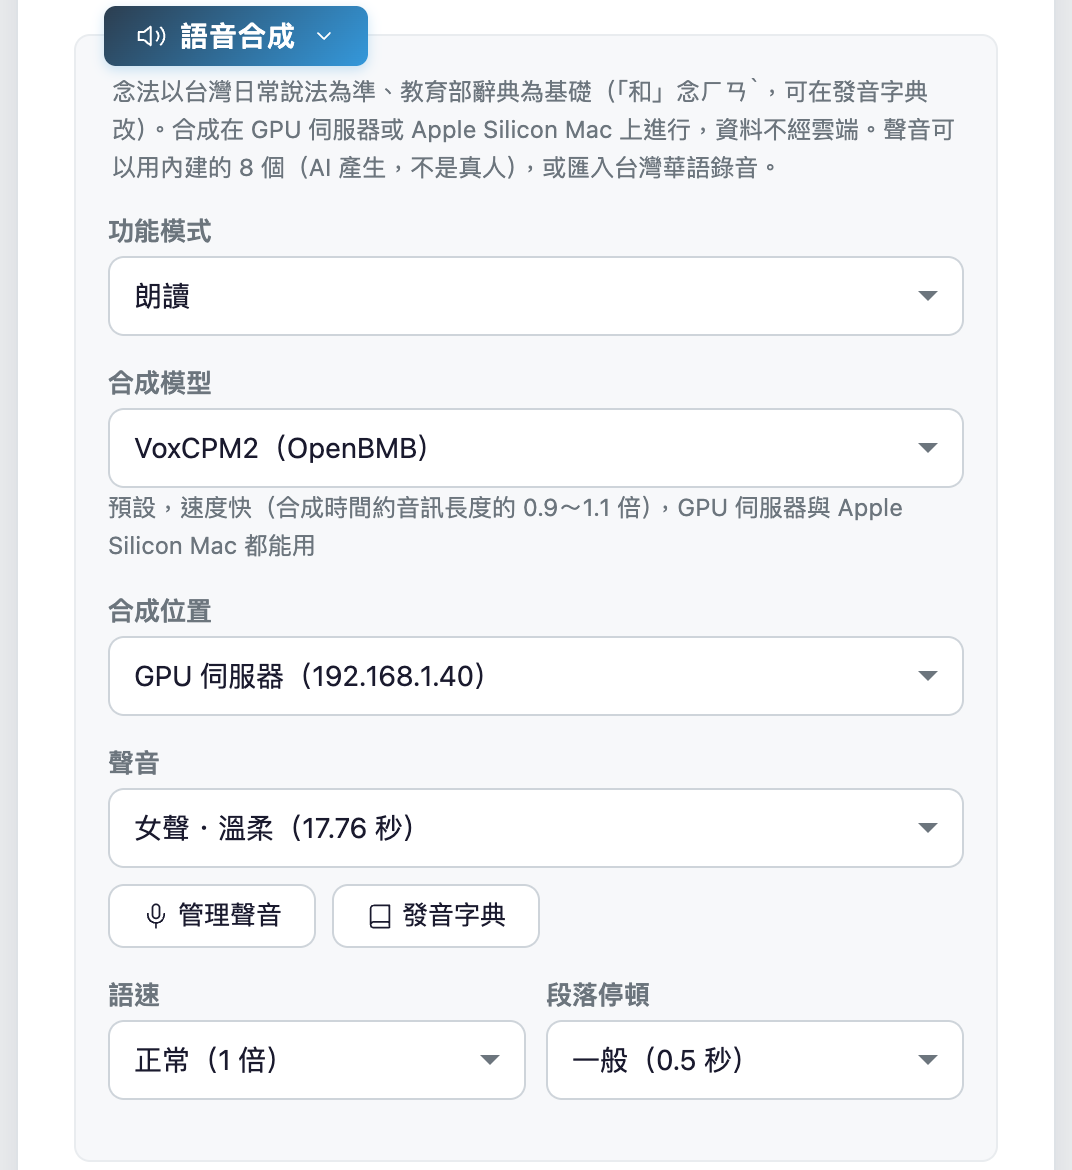
語速有慢(0.8 倍)、正常、稍快(1.2 倍)、快(1.5 倍),調整時音調不變,存成的音訊檔也是這個速度。段落停頓可以選 0.2、0.5 或 1 秒。
台灣念法的處理
以下說明的是預設的 VoxCPM2。送進模型之前,程式先決定每個字的台灣念法,通常只對和模型預設念法不同的字加上讀音提示,罕用字與模型已知容易念錯的字則一律指定:
- 教育部《重編國語辭典修訂本》為基礎
以詞為單位查辭典,同一個詞有多個讀音時(大家、便宜)依上下文挑。「垃圾」念ㄌㄜˋ ㄙㄜˋ、「星期」的「期」念ㄑㄧˊ,都是辭典本來的念法。 - 辭典和台灣日常說法不同的,改用日常說法
例如液晶的「液」念ㄧˋ、亞洲的「亞」念ㄧㄚˇ、市場的「場」念ㄔㄤˇ、強制的「強」念ㄑㄧㄤˊ,以及角色、參與等詞。 - 無法確定的念法由人試聽決定
做成同一句兩種念法試聽,蝸牛、優酪乳、從容這類詞最後決定照教育部的念法。 - 辭典沒收的詞由 g2pW 依上下文判斷
例如「伺服器」不在辭典裡,「伺」念ㄙˋ 是 g2pW 判斷的。 - 模型不認得的罕用字一律指定讀音
例如矽谷的「矽」和人名用字,送進模型的是拼音形式的讀音提示。
沒有指定讀音的字,會轉成簡體再送進模型。專案以 188 句自動偵測,疑似念錯的地方從 119 處降到 26 處。BreezyVoice 則不轉簡體,加注音的位置照它原本的規則,念法同樣採用台灣日常念法、教育部辭典與發音字典。
想知道一句話會怎麼念,可以在「發音字典」按「預覽念法」,大括號裡就是改用台灣念法的字。
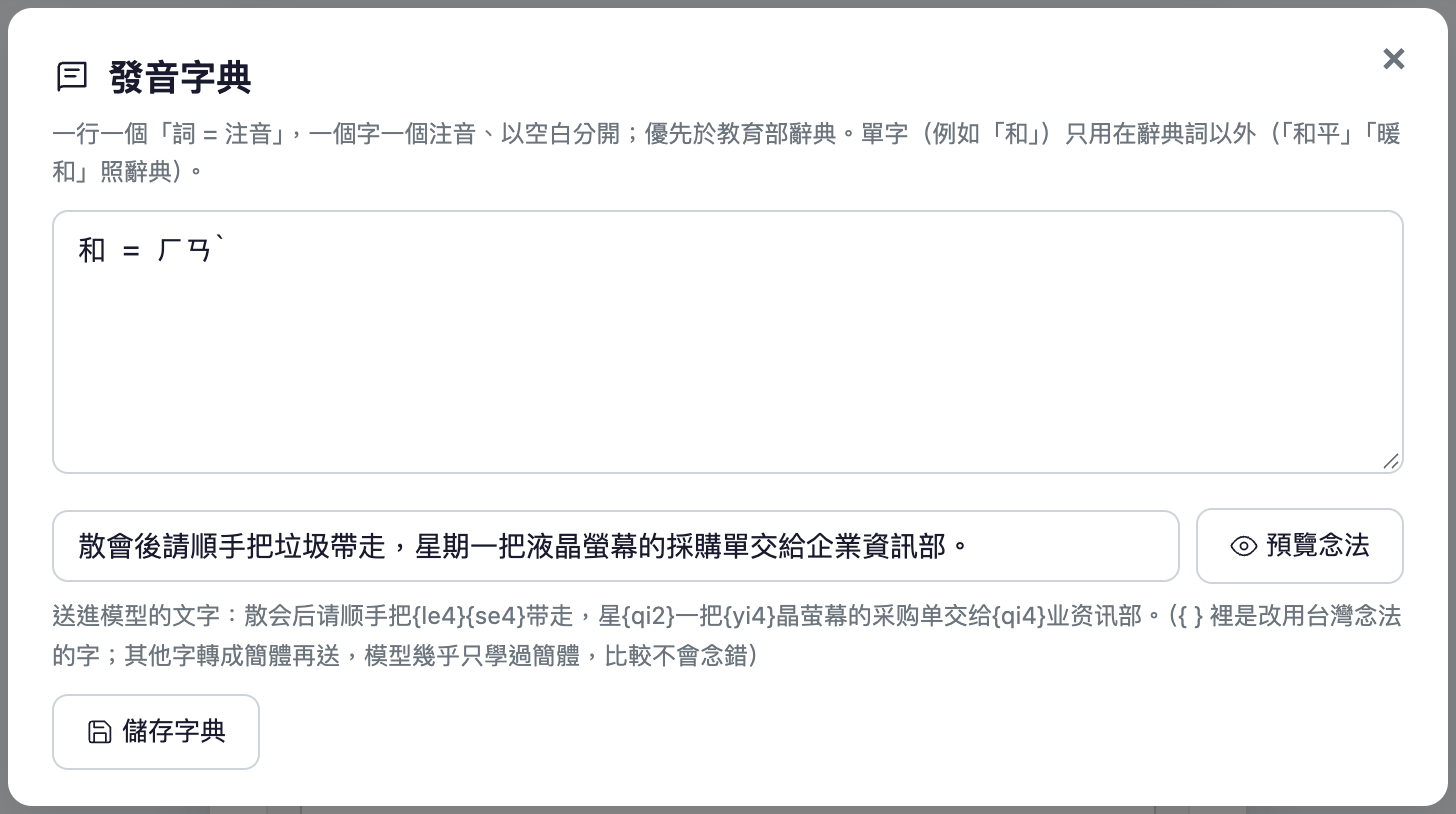
公司名稱、產品名稱或人名老是念錯的話,管理者可以在發音字典自己加,一行一個「詞 = 注音」,一個字一個注音、以空白分開。單字的自訂念法只用在辭典詞以外,例如預設的「和 = ㄏㄢˋ」不會影響「和平」「暖和」。
念法也經過大量自動檢查:用近 400 句台灣華語句子自動合成,再辨識回來逐字比對,並把將近 5,000 句裡指定的念法逐一檢查。不過語音辨識會把聲調錯誤「修正」回正確的字,自動檢查只能找出疑似念錯的地方,聲調與口音仍要靠人工試聽確認。
英文與數字
英文單字、縮寫、產品名,以及日期、時間、IP、版本號、電話、百分比這類寫法,模型大多念得對。實測會念錯的三種寫法,送進模型前會先轉換,預覽念法也看得到:
| 寫法 | 轉換後 |
|---|---|
| 千分位:1,250,000 | 一百二十五萬 |
| 負數:-5°C、-3.2% | 零下5度、負3.2% |
| 金錢符號:NT$3,500、$1,999 | 新台幣三千五百元、一千九百九十九美元($ 一律當美元,新台幣請寫 NT$) |
內建聲音
裝好就能用的聲音有 8 個,女聲、男聲各 4 個。它們都是 VoxCPM2 依文字描述產生的 AI 聲音,不是真人錄音,沒有選擇時預設用「女聲・溫柔」。
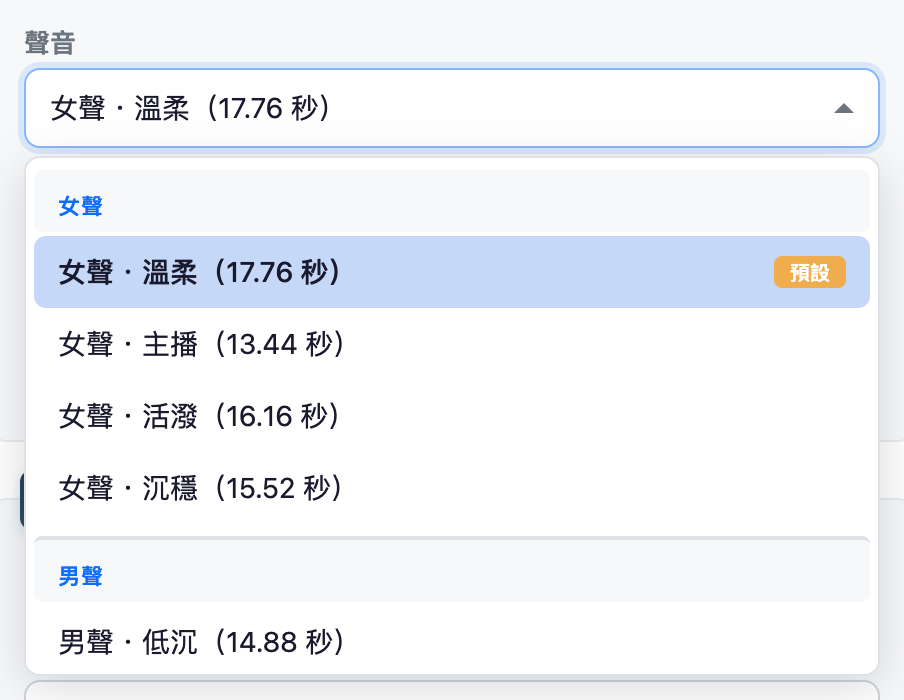
下面是 8 個聲音念同一句話,句子裡特別放了垃圾、星期、角色這幾個容易念錯的詞:「大家好,這是台灣華語朗讀的示範。星期五下午記得把垃圾拿去倒,新進同仁的角色分工也請再確認一次。」
上面截圖裡的兩次朗讀,產生的檔案如下,內容都是虛構的示範文字:
匯入自己的聲音
也可以匯入特定人的聲音。管理者在「管理聲音」上傳一段錄音,10~20 秒最好,附上一字不差的逐字稿。合成出來的音色、口音、節奏都來自這段錄音,所以要用台灣華語的錄音。
聲音屬於可以識別個人的資料,匯入前必須取得錄音者的書面同意,同意書的用途、範圍、期限與刪除方式請法務確認。匯入時要填寫錄音來源並勾選已取得同意,沒有勾選、沒有填寫就無法匯入;不過程式只檢查有沒有勾、有沒有填,同意是否屬實仍要由管理者負責。
硬體需求
| 合成位置 | 需求與速度 |
|---|---|
| GPU 伺服器 | 另外安裝 jt-live-whisper 伺服器端的 NVIDIA 顯示卡主機。VoxCPM2 在 DGX Spark 實測約佔 9.5 GB(行程 3.6 GB+顯示卡 5.8 GB,這台的 CPU 與 GPU 共用記憶體),可用記憶體不足 10 GB 時預設不啟動;BreezyVoice 約佔 7 GB,預設門檻 8 GB |
| Apple Silicon Mac 本機 | 記憶體 16 GB 以上,合成時另需約 7~10 GB,磁碟約 4 GB。預設擴散 6 步,Mac M5 實測約是音訊長度的 1.1 倍;改成音質較好的 10 步約 1.5 倍 |
| Windows 本機(NVIDIA 顯示卡,Beta) | v2.32.0 起。驅動要支援 CUDA 12.8 以上,需要 8 GB 以上顯示卡記憶體(實測載入後約佔 5 GB,合成時最多約 7 GB),不到 8 GB 時安裝與啟動都會提醒,磁碟約 20 GB。合成程式第一次用到時才啟動,閒置 10 分鐘自動結束並釋放顯示記憶體(v2.33.0 起口譯期間不會結束) |
本機合成支援 Apple Silicon Mac(16 GB 以上),以及 v2.32.0 起有 NVIDIA 顯示卡的 Windows(Beta),兩者都只用 VoxCPM2。Linux 即使有 NVIDIA 顯示卡,本機合成目前只在 Windows 提供安裝,仍要透過 GPU 伺服器;Intel Mac 不支援本機合成。合成位置預設是「自動」,依序使用 GPU 伺服器、Windows 本機 NVIDIA 顯示卡、Apple Silicon Mac 本機,有 GPU 伺服器時照樣先用 GPU 伺服器;要指定 Windows 本機,在「合成位置」選「本機(NVIDIA 顯示卡,beta)」,命令列是 --tts-provider cuda。
Windows 本機合成目前是 Beta:它和 GPU 伺服器用同一支合成程式,已在 Linux 搭配 NVIDIA(DGX Spark)實際合成,也在 Windows 跑過完整安裝流程與合成程式的啟動、閒置結束,但還沒有在 Windows 搭配 NVIDIA 顯示卡的實機上合成過。使用時遇到問題,歡迎到 GitHub 開 issue,並附上 tts_tmp\local_tts_worker.log。
另外兩點限制:
- BreezyVoice 只能在 GPU 伺服器上用,Apple Silicon Mac 與 Windows 本機都不提供。專案評估時在 Mac 上測過,合成時間約是音訊長度的 6 倍,太慢,所以沒有做成 Mac 本機的選項。
- 雙向語音口譯在 Windows、macOS、Linux 都能用,念出來的語音預設由 GPU 伺服器合成。從 v2.33.0 起,Windows 可以用本機 NVIDIA 顯示卡合成口譯語音,不必另外架 GPU 伺服器(Beta)。合成至少需要 8 GB 顯示記憶體,不夠時程式會提醒;辨識也在同一張卡上跑的話,建議 12 GB 以上。v2.34.0 起 Apple Silicon Mac 也可以在本機合成口譯語音(Beta),但 Mac 合成比說話慢,只適合偶爾說幾句的會議:以 MacBook Air 32 GB 實測,合成時間是語音長度的 1.5~2.7 倍,兩邊每 3 秒輪流說一句時,每句要等 8~20 秒才念出來。最順暢的做法仍是 GPU 伺服器或 Windows+NVIDIA 顯示卡。Linux 的口譯語音由 GPU 伺服器合成。
有 NVIDIA 顯示卡的 Linux 主機可以拿來當 GPU 伺服器,但伺服器端和用戶端裝在同一台的用法目前沒有測試過。
GPU 伺服器的合成程式第一次用到時才啟動,約等 30 秒,閒置 30 分鐘後自動關閉,把記憶體還給其他服務。
應用情境
- 把會議摘要、週報轉成 MP3 語音檔,下載後可以在手機或其他裝置上收聽。
- 把公告、教育訓練的文字稿轉成 MP3,放進簡報或內部網站。
- 文件太長、眼睛太累的時候,改用聽的。
- 搭配同一套工具箱的雙向口譯,線上會議時把對方的英文翻成中文念給自己聽。
目前的限制
- VoxCPM2 模型本身支援 30 種語言,但朗讀流程目前只針對台灣華語調校。中文裡夾雜英文沒問題,純英文或日文的文章還不建議。
- 合成速度和 GPU 伺服器忙不忙有關。DGX Spark 空閒時約是音訊長度的 0.9 倍,GPU 同時在跑其他工作時,會比說話慢。
- 同一個 WebUI 同一時間只做一件事,要朗讀得先停止正在進行的辨識。
- 念法調校仍在持續進行,遇到念錯的詞,可以先用發音字典修正。
線上語音合成服務參考
要念的是公開文章、教學稿或影片旁白時,線上服務很方便,也有台灣華語的選項。以下依各家官網 2026/11 的公開資訊整理,免費方式分成定期免費額度、限時試用與企業洽詢,商用授權條件也各不相同。
台灣的服務
| 服務 | 特色 | 免費方式 |
|---|---|---|
| 雅婷 Studio | 雅婷智慧(Taiwan AI Labs 的策略合作夥伴)的網頁配音服務,另有 TTS API | Studio 有「立即試用」入口;開發者平台新會員贈送等值新台幣 1,000 元點數,文字轉語音每十萬字元 298 元(未稅) |
| VoAI 絕好聲創 | 網際智慧的服務,主打台灣口音,有網頁配音與 API,也有地端 TTS Server(年授權或買斷,洽專人) | 註冊即可免費體驗,短篇配音上限 1,000 字、產生的檔案不可商用;API key 可免費試用,試用時有背景音樂/浮水印 |
| ATEN 優聲學 | 宏正自動科技的服務,可試聽台語、客語等聲音,也有客製聲音 | 免費方案只有標準聲優與中英語,單次 250 字、每月 2,500 字,可下載 WAV;台語要最高級方案 |
| 陽明交大人工智慧語音研發中心 | 研究中心(SARC)提供的線上語音合成 | 免費但採申請制:來信說明身分背景與使用目的,由中心視資源狀況審核 |
| 長問科技 BRONCI | 國語、台語、客語、英語的語音技術,以 API 提供語音合成,可接客服中心系統;官網寫技術涵蓋雲端到地端部署 | 沒有公開的免費自助額度,適合企業導入時洽詢 |
其他服務
| 服務 | 特色 | 免費方式 |
|---|---|---|
| Narakeet | 網頁貼上文字轉成語音檔,有 6 個台灣華語聲音 | 免註冊可轉換 20 次,每段文字最多 1 KB,免費版不可商用 |
| Microsoft Edge 朗讀 | 瀏覽器內建,直接朗讀網頁或 PDF | 免費;以播放為主,官方說明沒有提到存成音訊檔 |
| Azure AI Speech | 透過 API 或 SDK 串接,有 zh-TW 台灣華語神經語音 | F0 免費層的神經語音每月 50 萬字元 |
| Google Cloud Text-to-Speech | 透過 API 串接,台灣華語(cmn-TW)有 Standard 與 WaveNet 語音 | Standard 與 WaveNet 同一計費項目,每月前 400 萬字元免費,但要先啟用帳單 |
公開文稿可以先用線上服務試聽;要念的是內部會議摘要、未公開的公告或客戶文件時,就要先確認能不能把原文交給外部服務。我在 jt-live-whisper 做台灣華語朗讀,就是希望這類文稿能留在自己的設備上,邊合成邊聽,也能存成語音檔;公司名稱、人名或專有名詞念錯時,管理者可以在發音字典自己加注音。
免費額度、試用條件與商用授權可能變動,使用前請以各平台公告為準。
結論
文字轉語音不是新技術,但要念出台灣的說法、能即時朗讀,又不想把內部文字送上雲端,選擇並不多。jt-live-whisper 結合開源模型、教育部辭典與 g2pW,再用試聽與自動檢查補上台灣日常念法,在自己的設備上就能念出台灣的說法。
試聽時我最在意的是破音字與日常說法,這部分會隨著使用回報持續修正。
參考資料
- jt-live-whisper 專案網站
https://jasoncheng7115.github.io/jt-live-whisper/ - jt-live-whisper GitHub
https://github.com/jasoncheng7115/jt-live-whisper - jt-live-whisper 線上會議英中雙向口譯
https://blog.jason.tools/2026/11/jt-live-whisper-interp.html - 教育部《重編國語辭典修訂本》
https://dict.revised.moe.edu.tw/ - OpenBMB VoxCPM2
https://huggingface.co/openbmb/VoxCPM2 - MediaTek BreezyVoice
https://huggingface.co/MediaTek-Research/BreezyVoice - 雅婷 Studio 文字轉語音
https://studio.yating.tw/intro/zh-TW/tts - 雅婷開發者平台定價
https://developer.yating.tw/pricing - VoAI 絕好聲創價格與試用方案
https://www.voai.ai/pricing - ATEN 優聲學方案
https://www.aivoice.com.tw/priceplan - 陽明交大人工智慧語音研發中心服務說明
https://sites.google.com/nycu.edu.tw/sarc/tw-nlai/services - 長問科技 BRONCI 語音合成
https://www.bronci.com.tw/technology/tts - Narakeet 定價
https://www.narakeet.com/docs/pricing/ - Microsoft Edge 朗讀
https://explore.microsoft.com/zh-tw/edge/features/read-aloud - Azure AI Speech 定價
https://azure.microsoft.com/zh-tw/pricing/details/speech/ - Google Cloud Text-to-Speech 定價
https://cloud.google.com/text-to-speech/pricing