開會時大家講了很多,會後到底決定了什麼?誰要處理?什麼時候完成?
有錄音可以回去聽,但二十分鐘的會議再聽一次也是二十分鐘;轉成逐字稿好像方便一些,但幾百段文字還是得看完……負責寫會議記錄的同仁應該很有感。
這次 jt-doc-tools 的工具再加強:介接 jt-live-whisper 將會議錄音轉成逐字稿,再搭配 LLM 整理摘要、決議與待辦事項,連討論過程也能透過時間軸與結構圖呈現。而且整套可以全地端建置,語音辨識與 LLM 都部署在公司內部,會議資料不必出外網,也不需要上傳外部雲端 AI 服務。
摘要與查核
讓 AI 整理會議記錄,現在已經不是什麼新鮮事。但我在意的是另一件事:AI 寫得很順,不代表一定理解正確。
所以這次除了讓 AI 協助整理,也把摘要、圖表與原始逐字稿的對照一起做好。每一條摘要、決議、待辦,都指得回逐字稿裡是誰、在哪一段說的。整理出重點之後還要方便查核,才能確認 AI 有沒有理解錯誤。
整個流程分成兩支工具:
- 轉逐字稿
上傳錄音,交給 jt-live-whisper 做語音辨識與講者辨識 - 會議摘要
拿逐字稿交給 LLM 整理摘要、決議、待辦,並產生時間軸與結構圖
會議錄音轉逐字稿
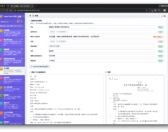
在 jt-doc-tools 上傳錄音,由介接的 jt-live-whisper 進行語音轉錄與區分發言者,產出帶有時間與發言者的逐字稿。
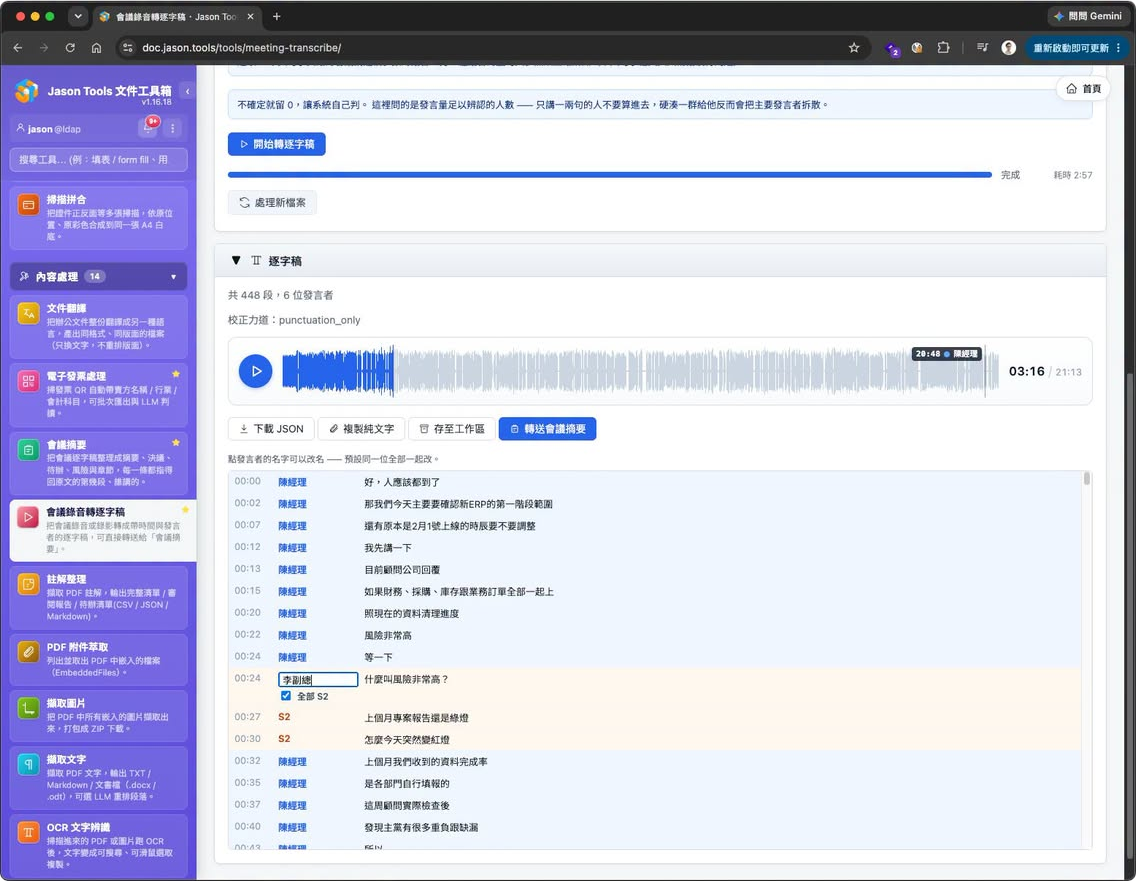
- 波形播放核對
搭配音訊波形播放,聽不清楚的地方可以直接跳到那個時間點核對內容 - 替發言者改名
辨識出來的發言者預設是代號,改成真實姓名後,同一位的其他段落會一起更新 - 直接轉送摘要
確認無誤後,一鍵轉送「會議摘要」工具處理,不用下載再上傳
摘要、決議與待辦
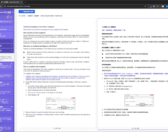
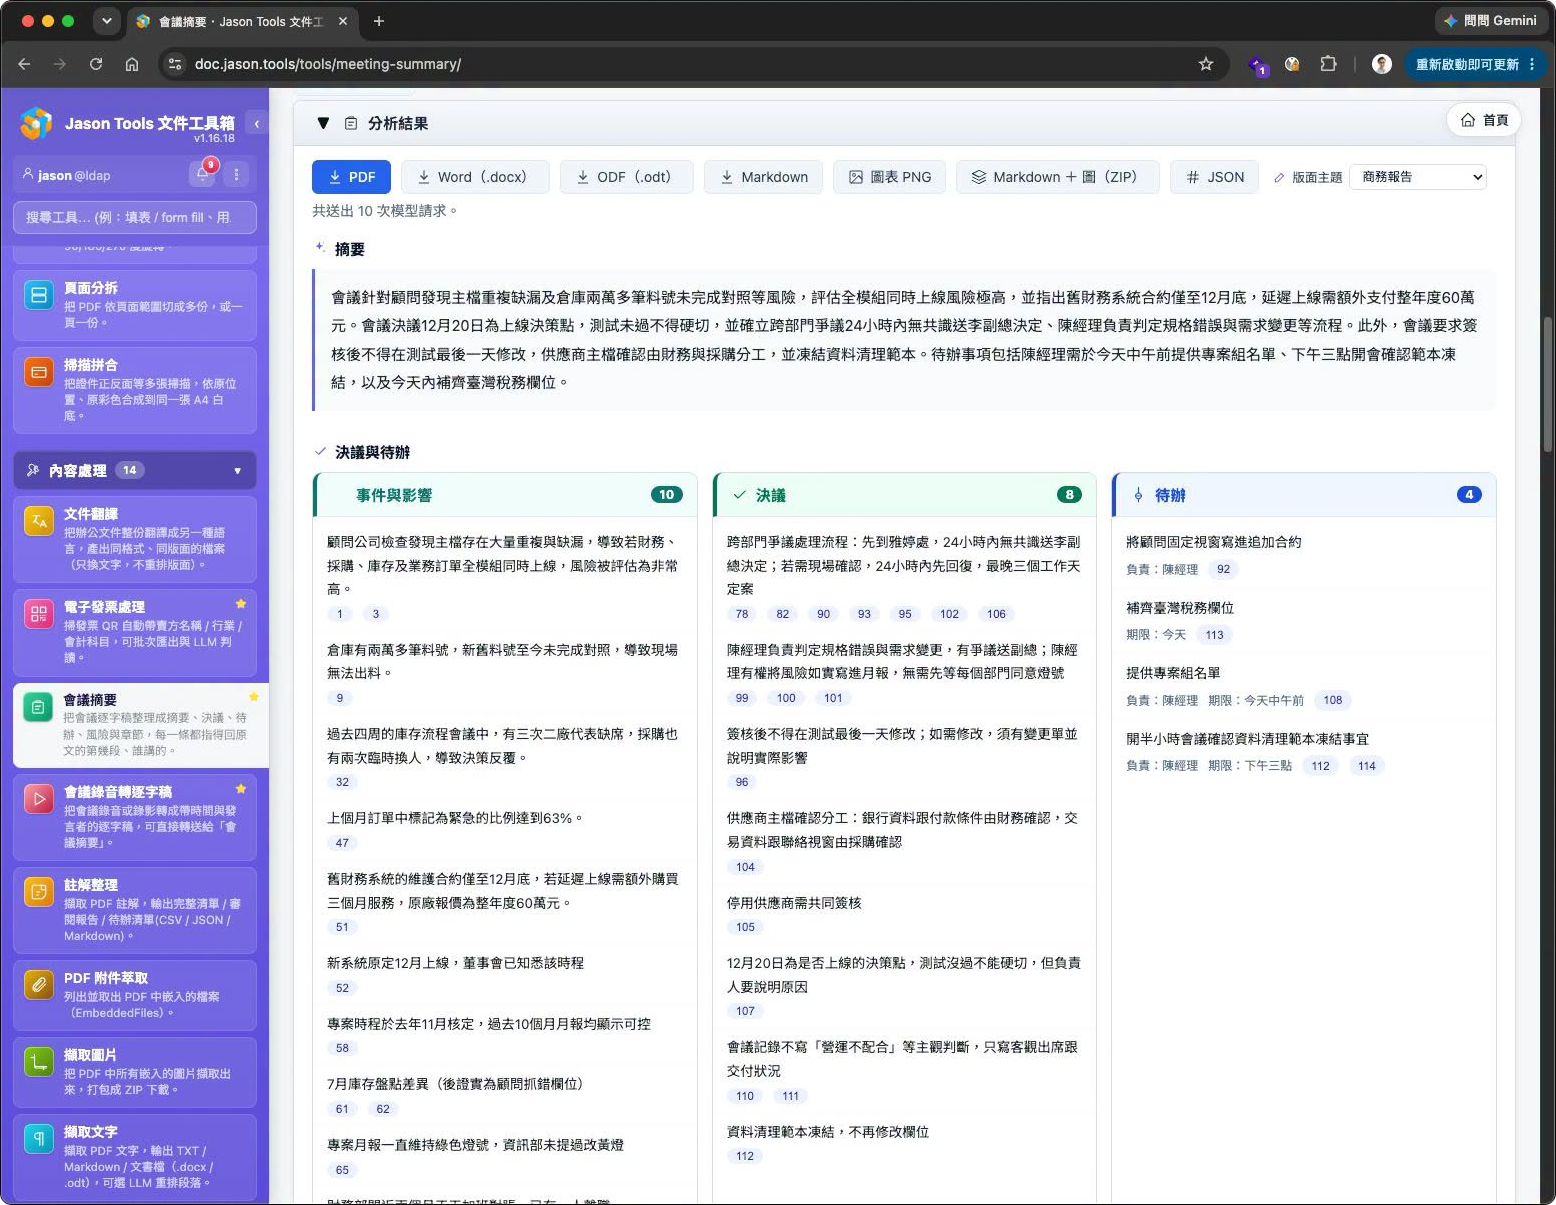
搭配 LLM 整理會議重點,將事件與影響、決議、待辦等內容分開呈現,並列出會議中有提到的負責人與期限。風險與未決問題也會另外整理出來,就是本文首圖的畫面。
每筆內容下方都有引用的逐字稿段落,方便回頭確認依據。而且這些引用不是 AI 說了算:抽出來的內容如果在它宣稱的段落裡找不到,就不會留下來,結果頁會說明丟掉了幾條;摘要裡出現的數字與英文詞,在逐字稿中找不到的也會列出來提醒。
整理好的結果可以匯出 PDF、Word、ODF、Markdown 等格式,供後續編修與分享。
議題時間分析
透過議題時間軸,可以查看各議題的討論順序、時間與占比;下方也有每位發言者的發言分布、次數、字數與時間。
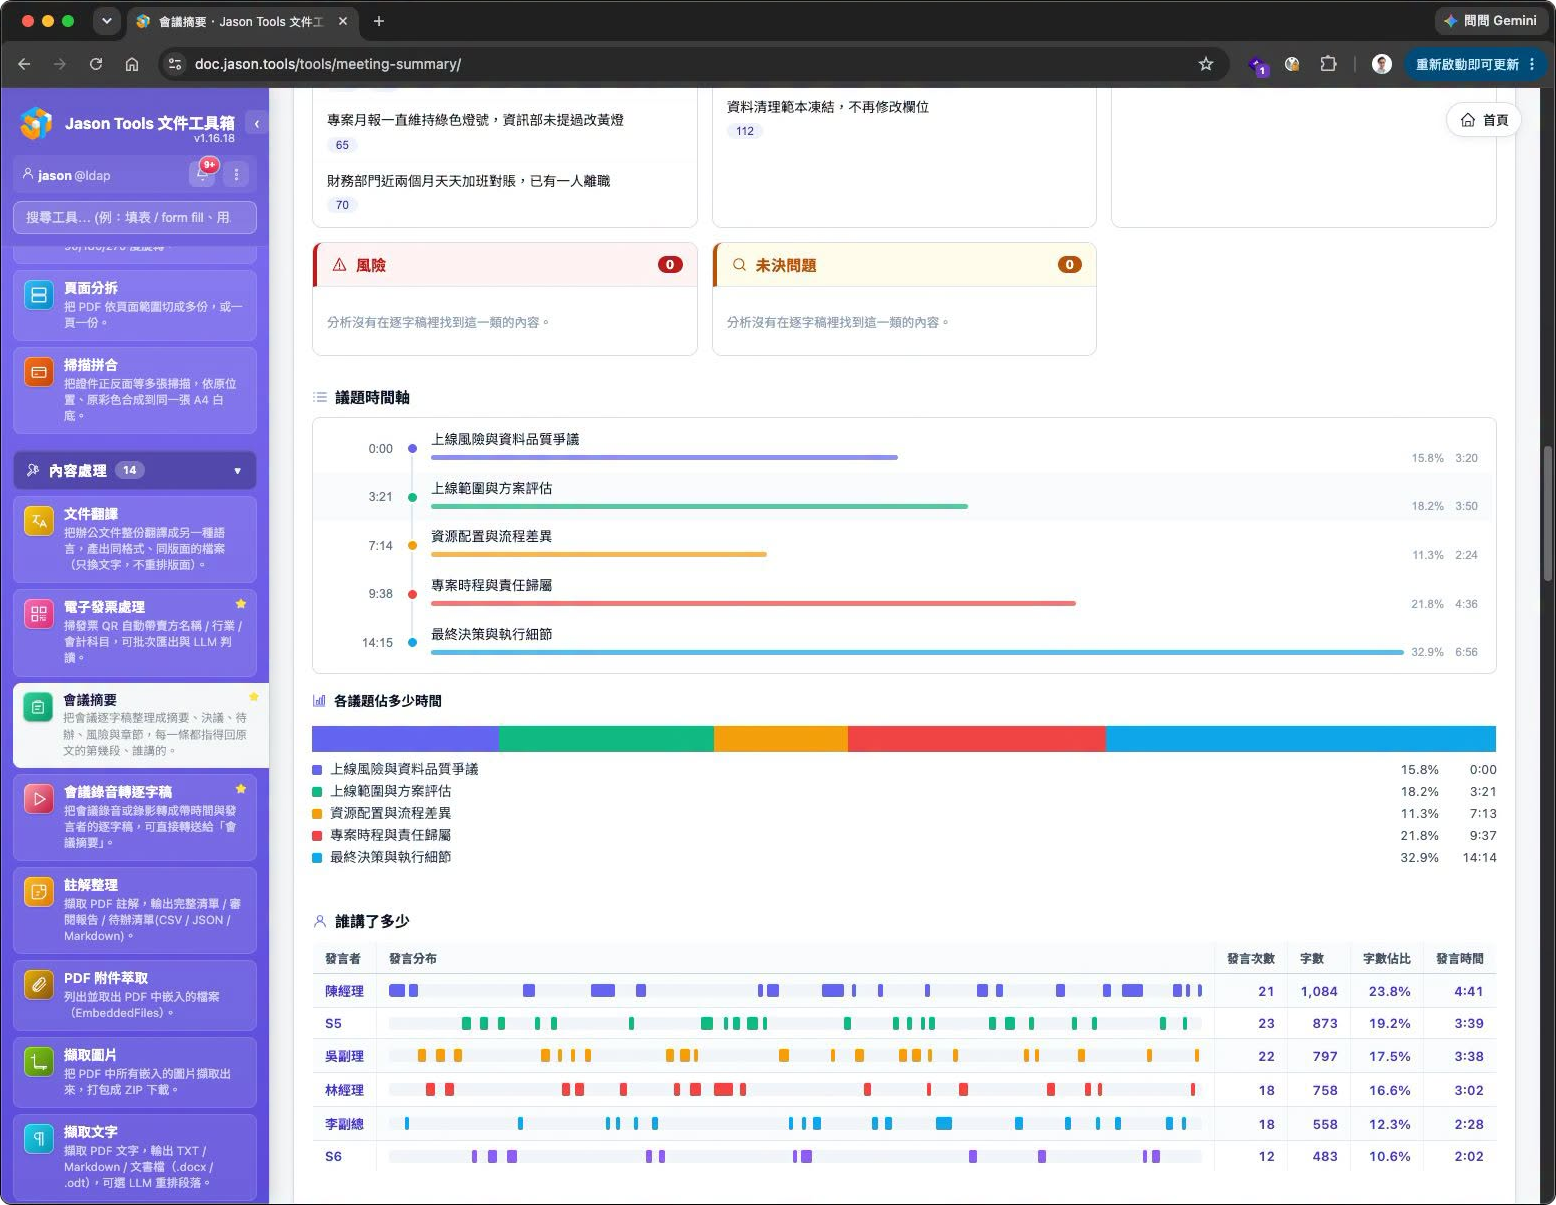
到底哪些議題談得久、哪些只帶過,透過圖表就比較容易掌握。至於講最多的是不是長官……這個就自己看了。
討論結構
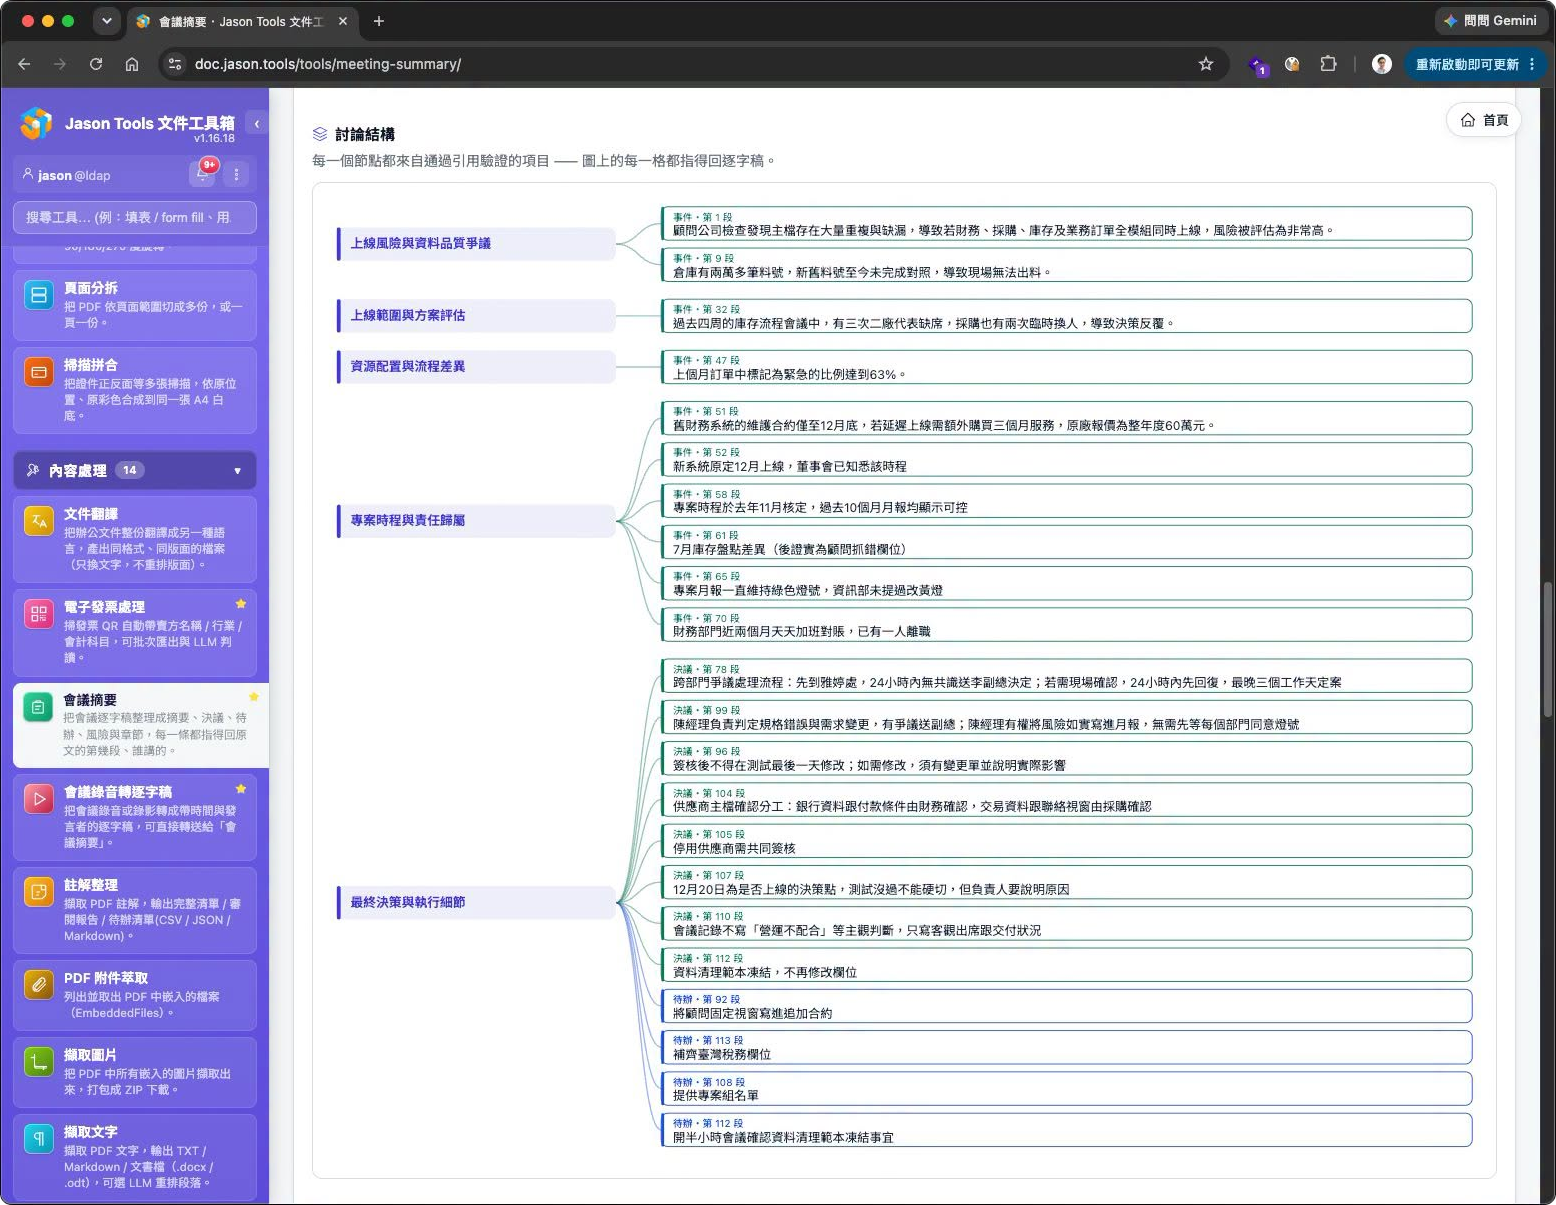
依據議題,將相關的事件、決議與待辦展開成結構圖,方便快速掌握各主題談了什麼、最後有哪些結論。圖上的項目也保留原文段落編號,可以再對照逐字稿確認。
逐字稿原文對照
「我當時不是這個意思」、「這件事我有答應嗎?」遇到這種狀況,就可以從摘要的引用回到逐字稿,確認發言者與前後文。
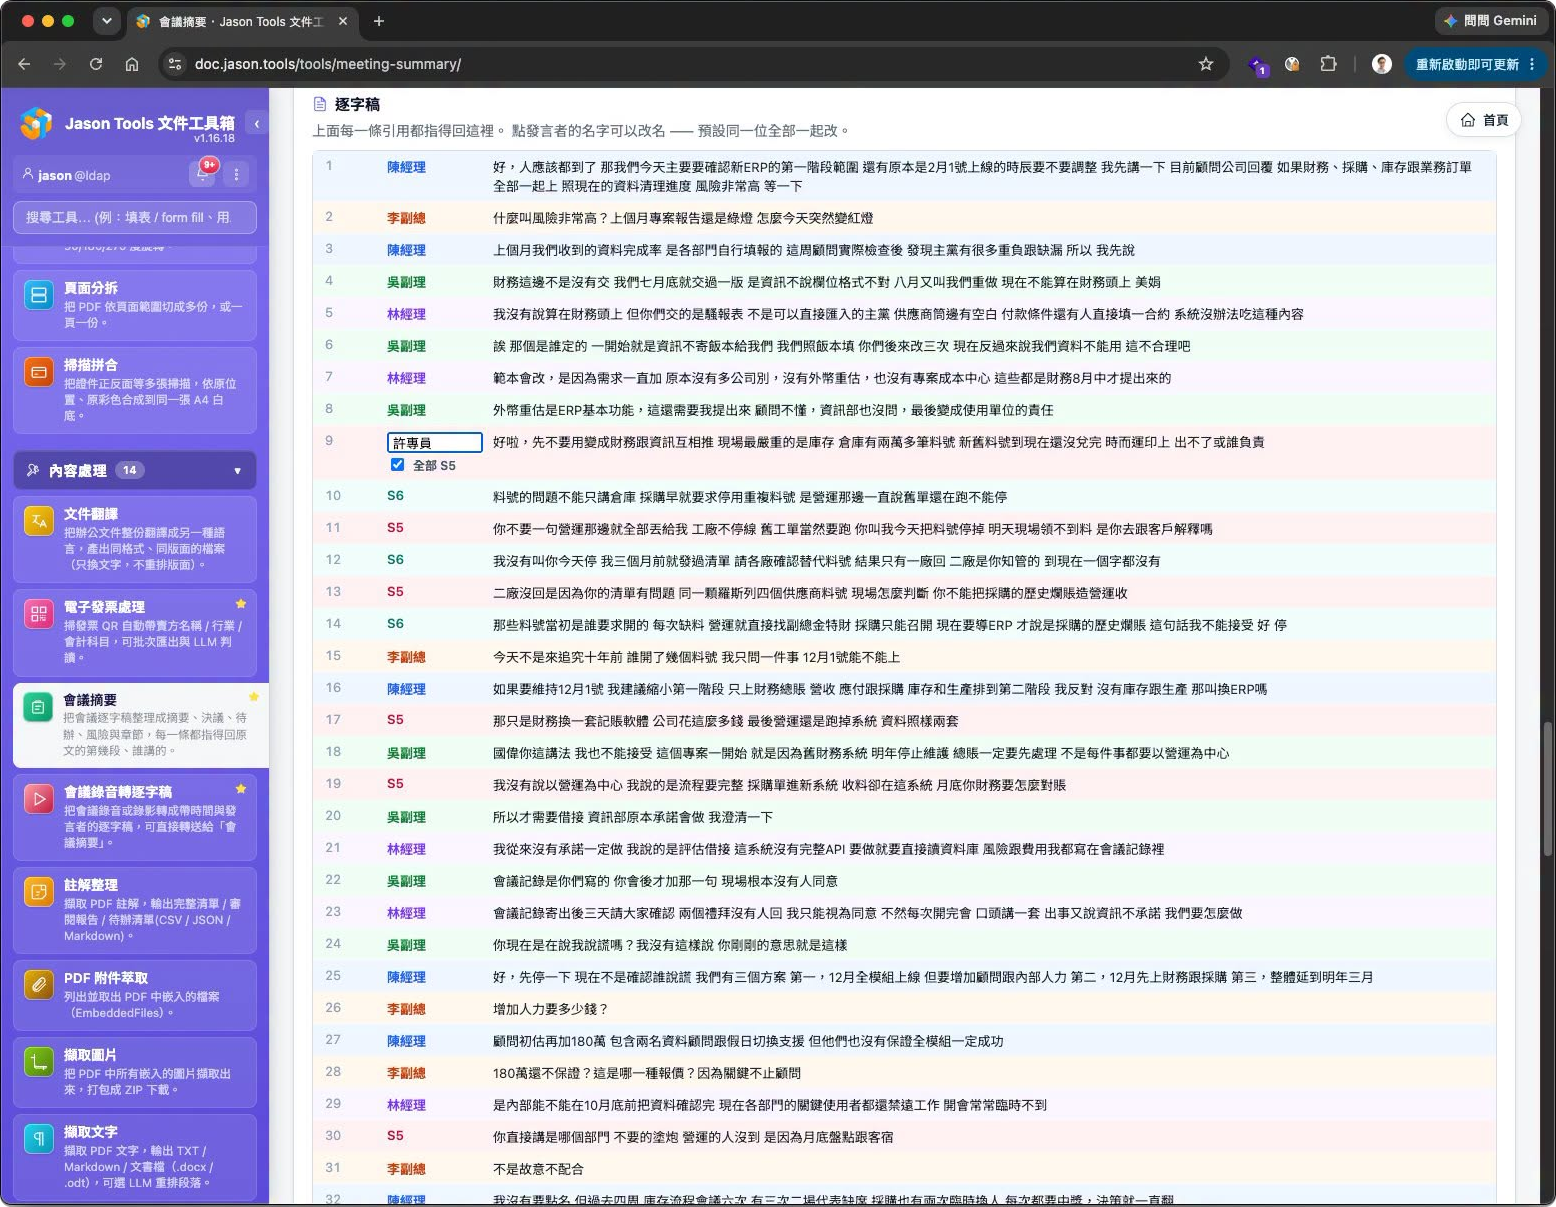
提醒:AI 寫得很順,不代表一定理解正確。正式發出會議記錄前,還是要有人確認;工具要做的,就是讓整理與查核都更省事。
全地端部署
會議內容常常包含客戶資料、報價與內部決策,這些東西我實在不想丟到外部的雲端 AI 服務。所以這整套的設計目標,就是從錄音轉逐字稿到產生摘要,全程在公司內網完成:
- 語音辨識
jt-live-whisper 以伺服器模式部署在公司內部,提供語音轉錄與講者辨識 - 摘要分析
jt-doc-tools 接公司內部的 LLM Server,例如 Ollama - 整合介面
同事只要開瀏覽器連 jt-doc-tools,上傳錄音、看結果、匯出文件
本文範例的語音辨識交由 JTLW(jt-live-whisper)處理,摘要分析採用 Qwen3.8 27B 模型,透過 Ollama 運作於 DGX Spark。
阿……圖中的 ERP 導入會議是虛構的測試內容。如果看起來很熟悉,那應該只是巧合。
結論
會議記錄最花時間的,其實不是打字,而是從一大段對話裡找出「到底決定了什麼」。AI 很適合做這件事,但前提是你能驗證它的結果,所以這次我花最多力氣的地方,是讓每一條結論都能點回原文。
加上全地端的部署方式,連機密會議也能放心交給它處理。負責寫會議記錄的同仁,以後可以把時間花在確認內容,而不是重聽錄音了。
參考資料
- jt-doc-tools:專案網站
https://jasoncheng7115.github.io/jt-doc-tools/ - jt-live-whisper:專案網站
https://jasoncheng7115.github.io/jt-live-whisper/ - jt-doc-tools 文件翻譯:保留原始格式與版面的辦公文件翻譯
https://blog.jason.tools/2026/09/jt-doc-translate.html - jt-doc-tools:自架的 PDF 與 Office 文件處理平台
https://blog.jason.tools/2026/07/jt-doc-tools-1.html