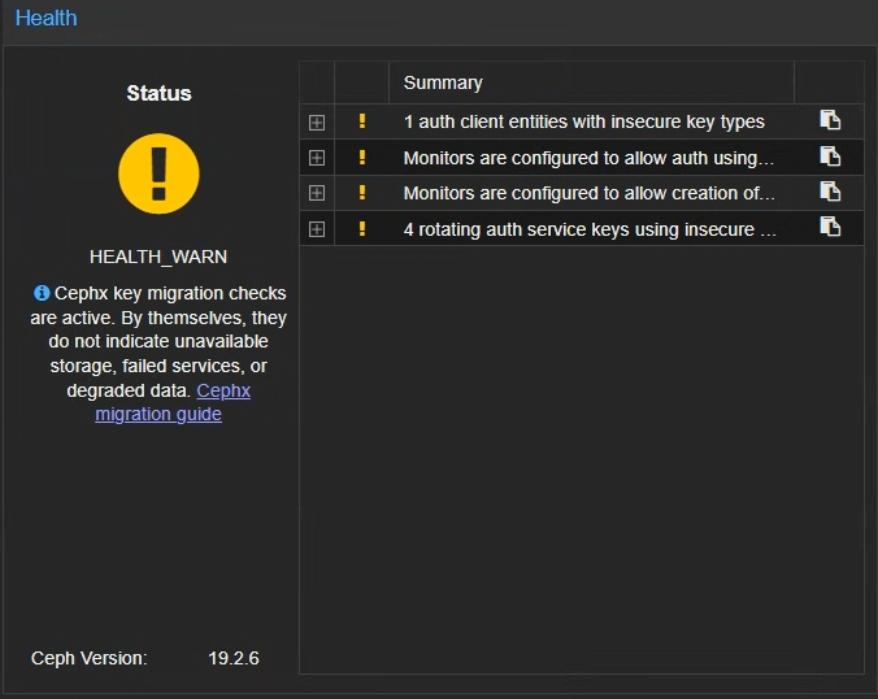
Ceph 升級到最新的修正版之後,PVE 的 Ceph 頁面突然多出一串 cephx 警告,甚至跳成 HEALTH_ERR,這時該先停下來檢查哪裡壞了嗎?
先確認健康狀態裡只剩這幾項 cephx 相關的檢查,就不必當成故障處理。這些警告來自 Ceph 的安全修正 CVE-2025-30156,它不代表儲存故障,而是提醒你舊類型的金鑰要換掉;但在換完並停用舊加密之前,漏洞也還沒真正補上。麻煩的是,只升級套件修不好,金鑰一定要輪替;而且 VM、CT、CephFS、外部主機各自用著金鑰,換的順序沒弄清楚,收尾時就會把還沒換好的用戶端擋在外面。
這篇整理我在自己與客戶的 PVE Ceph 叢集上做金鑰遷移的流程,重點是不另外排停機、跟著平常的維護慢慢完成,以及怎麼找出還在用舊金鑰的 VM 與 CT。
警告的來源
Ceph 的身分驗證機制叫 Cephx,每個服務與用戶端都有一把金鑰,連線時用它向 monitor 取得「票證」(ticket)。過去的金鑰類型 aes 用 AES-128-CBC 加密票證,但沒有完整性驗證、初始向量也是固定的。依 Ceph 官方的說明,攻擊者只要拿到一把低權限的金鑰,或能在網路上看到 Cephx 的密文,再加上能連到 Ceph 的網路,就能竄改密文、偽造 OSD、MDS、MGR 等服務的高權限憑證,這就是 CVE-2025-30156。
修正版是 Ceph Squid 19.2.6 與 Tentacle 20.2.4,新增了金鑰類型 aes256k。既有的金鑰仍是 aes,所以升級後叢集照常運作,但要另外把金鑰換成新類型,Ceph 也因此加了六項健康檢查來提醒。
PVE 在畫面上也直接註明:這些檢查本身不代表儲存無法使用、服務失敗或資料降級,並附上遷移指南的連結。六項檢查的意思與從哪一步處理:
| 健康檢查 | 意思 | 處理 |
|---|---|---|
AUTH_INSECURE_SERVICE_KEY_TYPE | Ceph 服務的金鑰是舊類型(HEALTH_ERR) | 步驟一 |
AUTH_INSECURE_SERVICE_TICKETS | monitor 用舊加密核發服務票證(HEALTH_ERR) | 步驟一 |
AUTH_INSECURE_CLIENT_KEY_TYPE | 使用者的金鑰是舊類型 | 步驟二 |
AUTH_INSECURE_ROTATING_SERVICE_KEY_TYPE | 輪替中的服務金鑰是舊類型 | 數小時內自行到期,不用等 |
AUTH_INSECURE_KEYS_ALLOWED | monitor 仍接受舊加密 | 步驟三 |
AUTH_INSECURE_KEYS_CREATABLE | monitor 仍可建立舊類型金鑰 | 步驟三 |
也就是說,看 ceph health detail 還剩哪幾項,就能判斷大致做到哪個階段。不過 AUTH_INSECURE_CLIENT_KEY_TYPE 從還沒分段到等待確認都會一直存在,中斷後回來接手時,要再搭配不加參數執行遷移腳本與 pveceph auth status,才知道確切進度。
遷移前的準備
PVE 提供了遷移輔助腳本 /usr/share/pve-manager/migrations/pve-cephx-rotate-service-keys,會檢查叢集、輪替金鑰,中斷後也能接續。下文的指令都用這支,先設個變數縮短:
H=/usr/share/pve-manager/migrations/pve-cephx-rotate-service-keys開始之前,下列條件都要符合:
- 每個節點 pve-manager 9.2.19 以上,Ceph 套件都更新到最新
- 每台 monitor「正在執行」的版本是 19.2.6-pve3、20.2.4-pve3 以上,分段輪替需要這個版本。要照本文「不停機」的方式做,則要到 -pve4:monitor 才能辨識每個連線用的是哪一把金鑰,換好的用戶端在確認時不必斷線;只有 -pve3 時,確認前該使用者所有看得到的用戶端都要中斷連線,像 RBD 儲存共用的
client.admin就等於要停掉所有 VM。後面列出舊連線的腳本也靠這個功能 - 所有 Ceph 服務都已滾動重新啟動到新版
- MON quorum 正常、OSD 全部 up/in、PG 全部
active+clean,除了AUTH_INSECURE_*沒有其他警告 - 每個節點都能用 SSH 連到
- Cephx 沒有被停用;若
auth_*_required = none,要改看官方文件的「Clusters with Cephx Disabled」
第三點最容易漏掉:PVE 更新 Ceph 套件不會自動重新啟動 Ceph 服務。下圖是客戶叢集的情況,套件已經是 19.2.7,OSD 卻還列在「Outdated OSDs」、執行 19.2.6,monitor 與 manager 旁邊也都有待更新的圖示,代表服務還沒重新啟動。這時要逐台重新啟動,一次只動一台,等叢集恢復正常再做下一台。
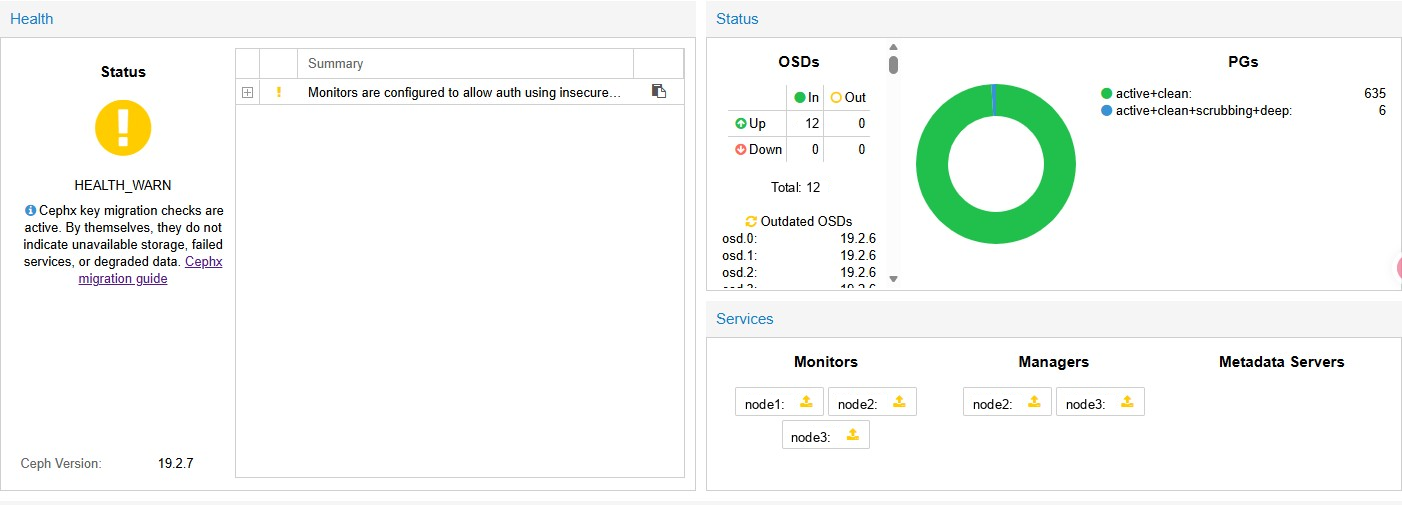
用指令確認:ceph versions 顯示的是各服務正在執行的版本,不是安裝的套件版本。
# 每個節點
pveversion -v | grep -E 'pve-manager|ceph'
uname -r

# 任一 Ceph 節點
ceph -s
ceph health detail
ceph versions腳本的使用規則:只在一個節點、以 root 執行;輪替類的選項不加 --apply 就是試跑(dry-run),只列出計畫,每一步都先試跑,確認沒有 blocker 才加 --apply;確認與回復類的選項(--confirm-…、--abort-staged-key)沒有試跑模式,一定要加 --apply,執行前先不加參數跑一次看狀態;每次執行完,不加參數再跑一次,照它印出的下一步做。已經換好的金鑰重跑不會再換一次。腳本執行期間不要同時做滾動重新啟動,也不要用其他工具改 Ceph 金鑰。
停機評估
這是客戶最關心的問題。整個遷移分三步,只有「讓用戶端換用新金鑰」這一段會動到 VM 與 CT,而且不必一次做完。表中的「不停機」指不必主動關閉客體,前提是叢集本來就承受得了一次停一個 Ceph 服務或一台節點(MON 數量、pool 副本數與失效域都要足夠):
| 階段 | VM | CT | 說明 |
|---|---|---|---|
| 步驟一:叢集金鑰 | 不停機 | 不停機 | Ceph 服務一次重新啟動一個,和一般滾動重新啟動相同;既有票證繼續有效 |
| 步驟二:分段換上新金鑰 | 不停機 | 不停機 | 新舊金鑰同時有效 |
| 步驟二:用戶端換新 | 線上遷移,或關機再開機 | 停止再啟動,實務上以節點為單位 | 可以跟著平常的維護慢慢完成 |
| 步驟三:收尾 | 不停機 | 不停機 | 前提是所有用戶端都已換好 |
我的做法是:做完步驟一,確認相容性後把新金鑰一次分段放好,之後不特地搬 VM、重新啟動 CT。新舊金鑰在確認前都有效,期限由自己決定,但舊加密在收尾前都還允許,最好依叢集網路的暴露程度訂個完成期限;遇到原本就要做的事,例如節點升級時 VM 被線上遷移、節點重新開機時 CT 跟著重新啟動,客體就自然換上新金鑰。沒有設定開機自動啟動(onboot)也不在 HA 管理的 CT,節點重新開機後會維持停止,維護前先記下原本執行中的客體,維護後逐一確認。期間不定期列出還在用舊金鑰的客體,最後剩下少數從來不搬的 VM、一直開著的 CT,再單獨安排。
這段期間 AUTH_INSECURE_CLIENT_KEY_TYPE 等警告會一直存在,可以先用 ceph health mute 加上期限靜音,靜音不會改變安全狀態。分段之前一定要處理的是 kernel 版本,後面說明;外部用戶端與金鑰副本則在收尾前處理。
步驟一:叢集自己的金鑰
$H --rotate-cluster-keys            # 試跑,檢查計畫
$H --rotate-cluster-keys --apply    # 沒有 blocker 才執行
這一步會換掉 manager、MDS、OSD、monitor、bootstrap、crash,以及加密 OSD 的 lockbox 金鑰,需要時一次重新啟動一個服務,包括 monitor。儲存使用者的金鑰與 client.admin 不會動,既有票證繼續有效,舊加密也還允許。
完成後,兩項 HEALTH_ERR(SERVICE_KEY_TYPE、SERVICE_TICKETS)會消失,pveceph auth status 可以看各服務金鑰的加密類型。OSD 重新啟動後可能短暫出現 misplaced、backfilling,要等 PG 全部回到 active+clean 再做下一步:
  data:
    volumes: 1/1 healthy
    pools:   4 pools, 193 pgs
    objects: 1.77M objects, 6.3 TiB
    usage:   12 TiB used, 14 TiB / 26 TiB avail
    pgs:     7310/5320095 objects misplaced (0.137%)
             190 active+clean
             2   active+remapped+backfilling      ← 還在搬移,先不要進步驟二
             1   active+clean+scrubbing+deep      ← scrub 不影響,可以繼續
AUTH_INSECURE_ROTATING_SERVICE_KEY_TYPE 可能要幾個小時才會消失,那是舊的輪替金鑰自然到期,不必等它。
步驟二:使用者金鑰
先確認相容性
一個 Ceph 使用者可能被很多東西共用,例如 PVE 自建 Ceph 的 RBD 儲存預設就用 client.admin。所有用到它的用戶端都支援 aes256k 才能換,包括目前離線的和外部的。PVE 更新後的 Ceph 套件都支援,問題在 kernel 用戶端:
| 用到 Ceph 的東西 | 用戶端 | 需要 |
|---|---|---|
| VM 的 RBD 磁碟(未啟用 krbd) | userspace(librbd) | 已更新的 PVE Ceph 套件 |
| 放在 RBD 上的 CT、啟用 krbd 的 VM | kernel | 正在執行的 kernel 7.0 以上 |
| CephFS(預設) | kernel | 掛接端正在執行的 kernel 7.0 以上 |
| CephFS 啟用 fuse | userspace | 掛接端已更新的 Ceph 套件 |
| 外部 PVE、Linux 主機 | 依該系統 | 要自己確認 |
uname -r                                                  # 每個節點都要查
grep -E '^(rbd|cephfs):|krbd|fuse' /etc/pve/storage.cfg   # 哪些儲存用 kernel 用戶端
注意:只安裝了新 kernel、還沒重新開機不算。只要有 CT 放在 RBD 上,分段之前節點正在執行的 kernel 就要 7.0 以上,否則分段之後任何一台 CT 重新啟動,都會拿到它用不了的新金鑰而啟動失敗。有任何用戶端不相容或無法確認,那個使用者的金鑰先不要換。
分段換上新金鑰
$H --rotate-all-storage-keys --rotate-admin-key            # 試跑
$H --rotate-all-storage-keys --rotate-admin-key --apply
--rotate-all-storage-keys 處理本機 RBD 與 CephFS 儲存專用的使用者,--rotate-admin-key 處理 client.admin,這個組合適用於所有目標使用者都相容的情況。只想先換部分儲存,可以改用 $H --rotate-storage-key <儲存 ID>(同樣先試跑再加 --apply),共用同一個 Ceph 使用者的用戶端仍要全部相容;client.admin 要不要一起換另外判斷。新金鑰會寫進 PVE 管理的 keyring 與 secret 檔,在確認之前新舊兩把都有效,用戶端可以慢慢換。外部叢集的儲存不會被處理,要依那座叢集管理者的程序。分段期間不要新增或降級 monitor,也不要用其他工具改這些使用者的金鑰。
讓用戶端換用新金鑰
| 用戶端 | 操作 |
|---|---|
| VM | 網頁介面線上遷移,或關機再開機。在 VM 裡面重新開機不算,要讓 PVE 端的 QEMU 程序重新啟動 |
| CT、其他 RBD 用戶端 | 停止再啟動;同一節點的 CT 共用連線,實務上以節點為單位(見下一節) |
| CephFS | 腳本會自動處理閒置的掛接;使用中的等沒人用之後再跑一次 $H --apply。VM 掛著 CephFS 上的 ISO 時,要先卸下 ISO 或把 VM 移到別的節點 |
| 外部用戶端 | 從 /etc/pve/priv/ceph/<儲存 ID>.keyring(RBD)、.secret(CephFS)或 /etc/pve/priv/ceph.client.admin.keyring 複製新金鑰過去,再重新啟動或重新掛接。每個用戶端用它自己那個使用者的金鑰,不要拿 client.admin 代替 |
設了 monhost 的儲存 | 即使指向本機叢集,也被當成外部的,腳本不會更新它的金鑰,要自己貼上新金鑰 |
正在跑的備份、還原、磁碟匯入與 clone 會一直用開始時的金鑰,收尾前要等它們全部結束。
找出還在用舊金鑰的 VM 與 CT
不加參數執行 $H,它會列出可能還在用舊金鑰的連線;能找到 kernel 用戶端時,會指出對應的 RBD 裝置與設定使用它的 CT 或 VM,但其他提示(例如從某個節點連線的 VM)只到主機層級,官方文件也說明它不是完整的客體清單。客戶叢集有五十多台客體,要知道到底是哪一台,我寫了一支只讀的 Perl 腳本來對照,原理是:
- 取出使用者(預設
client.admin)待確認新金鑰的指紋 - 問每一台 monitor:這個使用者目前有哪些連線、各用哪把金鑰的指紋(需要 monitor -pve4 以上)
- 讀每台客體目前的設定(不含快照段落),找出用到這個儲存的映像,再用
rbd status查是哪個連線在使用它 - 兩邊對起來,列出還掛在舊連線上的客體
這支腳本的適用範圍是本機叢集、沒有設定 namespace 的 RBD 儲存,遇到設了 monhost 或 namespace 的儲存會直接拒絕;linked clone 的磁碟(名稱是 base-…/vm-…)取最後一段當映像名稱。另存為 /root/cephx-old-clients.pl,在任一節點執行,參數是儲存 ID,RBD pool 與 Ceph 使用者預設取自該儲存的設定,也可以另外指定(使用者寫 admin 或 client.admin 都可以)。磁碟設定寫成 file=、volume= 的形式也認得。有多個 RBD 儲存時,每個各跑一次。前提是分段已經 --apply,否則會回報 No pending key for client.admin。
#!/usr/bin/perl
# 列出仍用舊 Cephx 金鑰連線的 VM、CT。只讀,不改任何東西。
# 用法:perl cephx-old-clients.pl <儲存 ID> [<RBD pool>] [<Ceph 使用者>]
#   儲存 ID:/etc/pve/storage.cfg 裡 RBD 儲存的名稱,例如 ceph1:vm-100-disk-0 的 ceph1
#   RBD pool、Ceph 使用者:預設取自該儲存的設定 (沒設定時為 rbd、admin);使用者寫 admin 或 client.admin 皆可
# 適用:本機叢集、沒有設定 namespace 的 RBD 儲存 (設了 monhost 或 namespace 會直接拒絕)
# 前提:已執行 --rotate-all-storage-keys --rotate-admin-key --apply (有待確認的新金鑰)
use strict;
use warnings;
use utf8;
use JSON::PP;
use Digest::SHA qw(sha256_hex);
use PVE::Tools;
use PVE::Storage;

my $sid = shift // die "usage: $0 <storage-id> [<pool>] [<ceph-user>]\n";
my $scfg = PVE::Storage::config()->{ids}{$sid} // die "Storage $sid not found\n";
die "Storage $sid is not RBD\n" unless ($scfg->{type} // '') eq 'rbd';
die "Storage $sid uses monhost (external cluster), not supported\n" if $scfg->{monhost};
die "Storage $sid uses a namespace, not supported\n" if $scfg->{namespace};
my $pool = shift // $scfg->{pool} // 'rbd';
my $user = shift // $scfg->{username} // 'admin';
$user =~ s/^client\.//;
$user = "client.$user";

sub J {
    my ($label, $cmd) = @_;
    my ($out, $err) = ('', '');
    eval {
        PVE::Tools::run_command($cmd,
            outfunc => sub { $out .= "$_[0]\n" },
            errfunc => sub { $err .= "$_[0]\n" },
            timeout => 30);
        1;
    } or die "$label failed:\n" . ($err || "Command failed or timed out\n");
    my $data = eval { decode_json($out) };
    die "$label: invalid JSON\n" if $@;
    return $data;
}

my @opts = ('-c', '/etc/pve/ceph.conf', '-n', 'client.admin',
            '--keyring', '/etc/pve/priv/ceph.client.admin.keyring');

# 新金鑰的指紋 (待確認的那一把)
my $auth = J('auth', ['ceph', @opts, 'auth', 'get', $user, '-f', 'json'])->[0];
die "No pending key for $user\n" unless $auth->{pending_key};
my $target = substr(sha256_hex($auth->{pending_key}), 0, 16);

# 每個 monitor 上這個使用者的連線:哪些用新金鑰、哪些用舊金鑰
my (%old, %new, %seen, %vols, @rows, @skipped);
for my $mon (@{ J('monmap', ['ceph', @opts, 'mon', 'dump', '-f', 'json'])->{mons} }) {
    for my $s (@{ J("mon.$mon->{name}", ['ceph', @opts, 'tell', "mon.$mon->{name}", 'sessions']) }) {
        next unless ($s->{con_type} // '') eq 'client' && ($s->{entity_name} // '') eq $user;
        die "Missing client ID or key fingerprint\n"
            unless defined($s->{global_id}) && $s->{auth_key_fingerprint};
        my $id = $s->{global_id};
        if ($s->{auth_key_fingerprint} eq $target) { $new{$id} = 1 }
        else { $old{$id}{ $s->{socket_addr}{addr} // 'unknown' } = 1 }
    }
}

# 每台客體目前設定 (不含快照段落) 用到這個儲存的哪些映像
# linked clone 的磁碟寫成 base-900-disk-0/vm-100-disk-0,實際映像是最後一段
my $guests = J('guests', ['pvesh', 'get', '/cluster/resources', '--type', 'vm', '--output-format', 'json']);
for my $g (@$guests) {
    my $type = $g->{type} eq 'qemu' ? 'qemu-server' : 'lxc';
    my $path = "/etc/pve/nodes/$g->{node}/$type/$g->{vmid}.conf";
    unless (-f $path) { push @skipped, $g->{vmid}; next }
    open my $fh, '<', $path or die "$path: $!\n";
    my $text = do { local $/; <$fh> };
    my ($active) = split /\n\[/, $text, 2;
    my %images;
    while ($active =~ /^(?:(?:scsi|virtio|sata|ide)\d+|efidisk0|tpmstate0|rootfs|mp\d+):\s*(?:(?:file|volume)=)?\Q$sid\E:([^,\s]+)/mg) {
        my ($image) = $1 =~ m{([^/]+)\z};
        $images{$image} = 1;
    }
    push @{ $vols{$_} }, $g for keys %images;
}

# 每個映像目前的 watcher (正在使用它的 client),對照上面的連線
# 不在 monitor 清單裡的 watcher (查詢期間重新連線、其他使用者) 標成 UNKNOWN,不略過
my $unknown_total = 0;
for my $image (sort keys %vols) {
    my $status = J("$pool/$image", ['rbd', @opts, 'status', "$pool/$image", '--format', 'json']);
    die "Invalid watchers for $image\n" unless ref($status->{watchers}) eq 'ARRAY';
    my %clients;
    for my $w (@{ $status->{watchers} }) {
        die "Missing watcher client ID for $image\n" unless defined $w->{client};
        my $id = $w->{client};
        $id =~ s/^client\.//;
        $clients{$id} = 1;
    }
    my @stale   = sort { $a <=> $b } grep { exists $old{$_} } keys %clients;
    my @unknown = sort { $a <=> $b } grep { !exists($old{$_}) && !$new{$_} } keys %clients;
    next unless @stale || @unknown;
    $seen{$_} = 1 for @stale;
    $unknown_total += @unknown;
    my $mixed = grep { $new{$_} } keys %clients;
    for my $g (@{ $vols{$image} }) {
        my $result = !@stale ? 'UNKNOWN'
                   : ($mixed || @unknown || @{ $vols{$image} } > 1) ? 'CHECK' : 'OLD';
        my $action = $result ne 'OLD'                   ? 'CHECK_WATCHERS'
                   : ($g->{status} // '') ne 'running'  ? 'CHECK_STOPPED'
                   : $g->{type} eq 'qemu'               ? 'MIGRATE_OR_STOP_START'
                   :                                      'STOP_START';
        push @rows, [$g->{node}, $g->{type} eq 'qemu' ? 'VM' : 'CT', $g->{vmid}, $g->{name} // '',
                     $g->{status} // 'unknown', $result, $action, $image,
                     join(',', @stale) || '-', join(',', @unknown) || '-'];
    }
}

print "NODE TYPE ID NAME STATUS RESULT ACTION IMAGE OLD_CLIENT_IDS UNKNOWN_CLIENT_IDS\n";
print join(' ', @$_), "\n" for sort { $a->[2] <=> $b->[2] || $a->[7] cmp $b->[7] } @rows;
my @left = sort { $a <=> $b } grep { !$seen{$_} } keys %old;
print 'UNRESOLVED_CLIENT_IDS ', scalar(@left), "\n";
print "UNRESOLVED $_ ", join(',', sort keys %{ $old{$_} }), "\n" for @left;
print "UNKNOWN_WATCHERS $unknown_total\n";
print 'SKIPPED_GUESTS ', scalar(@skipped), (@skipped ? ' ' . join(',', sort { $a <=> $b } @skipped) : ''), "\n";
perl /root/cephx-old-clients.pl ceph1實際輸出的節錄(節點與客體名稱已換成示範名稱)。實際執行的是前一版腳本,這裡已換成目前版本的欄位格式:
NODE     TYPE ID  NAME    STATUS  RESULT ACTION                IMAGE         OLD_CLIENT_IDS UNKNOWN_CLIENT_IDS
node-c   CT   100 ct-100  running OLD    STOP_START            vm-100-disk-0 657348996      -
node-d   VM   102 vm-102  running OLD    MIGRATE_OR_STOP_START vm-102-disk-0 657303115      -
node-e   CT   104 ct-104  running OLD    STOP_START            vm-104-disk-0 690395798      -
node-d   CT   108 ct-108  running OLD    STOP_START            vm-108-disk-0 651572183      -
node-c   VM   112 vm-112  running OLD    MIGRATE_OR_STOP_START vm-112-disk-0 657474303      -
node-b   CT   115 ct-115  running OLD    STOP_START            vm-115-disk-1 651504834      -
node-b   CT   116 ct-116  stopped OLD    CHECK_STOPPED         vm-116-disk-0 651504834      -
...
UNRESOLVED_CLIENT_IDS 0
UNKNOWN_WATCHERS 0
SKIPPED_GUESTS 0| 結果 | 意思與處理 |
|---|---|
OLD + MIGRATE_OR_STOP_START | VM 設定的映像有舊連線在使用:多半是該 VM,線上遷移或關機再開機 |
OLD + STOP_START | CT 設定的映像有舊連線在使用:停止再啟動(注意下面的共用連線) |
OLD + CHECK_STOPPED | 客體已停止,映像卻仍被舊連線使用:到該節點用 rbd showmapped 確認沒在用再處理 |
CHECK + CHECK_WATCHERS | 同一映像新舊連線混在一起、有對不上的連線,或被多台客體共用:用 rbd status <pool>/<image> 逐一核對 |
UNKNOWN + CHECK_WATCHERS | 映像的連線不在 monitor 列出的清單裡(查詢期間重新連線、或是其他 Ceph 使用者),列在 UNKNOWN_CLIENT_IDS,稍後重跑或逐一核對 |
UNRESOLVED_CLIENT_IDS | 用舊金鑰、但對不到任何客體的連線(外部用戶端、ceph 指令、備份作業等),不是 0 時會列出來源 IP,要逐一查清楚。是 0 也只代表目前看到的舊連線都對得上某個映像,不代表遷移完成 |
腳本是先問 monitor、再逐一查映像,中間有用戶端重新連線,就會出現對不上的連線,所以這類連線一律列成 UNKNOWN,總數在 UNKNOWN_WATCHERS;找不到設定檔的客體則記在 SKIPPED_GUESTS。這兩個數字不是 0 時,清單就不完整。即使全部是 0,最後仍以遷移腳本的檢查與離線用戶端的盤點為準。
這一版補上 linked clone、未知連線與儲存設定的檢查後,我只用模擬資料測過,還沒在實際叢集執行,第一次使用時請先對照遷移腳本的輸出。
CT 共用連線的觀察
對照清單時發現一個現象:每台 VM 都有自己的連線 ID,同一節點上的 CT 卻都列出同一個舊 ID,連已停止的 CT 也是(上面 node-b 的 115 與 116)。原因是 VM 的磁碟(未啟用 krbd 時)由各自的 QEMU 程序透過 librbd 連線;CT 用的是 kernel RBD,Linux 的 RBD 驅動預設會讓同一台主機上、連到同一座叢集且選項與金鑰都相同的 RBD 裝置共用一個 Ceph 用戶端。
金鑰也是比對條件,所以分段之後重新啟動的 CT,只要舊的 RBD 對應確實解除、再用新金鑰重新對應,就會另開一個新連線(PVE 發現裝置已經對應時會直接沿用,不會重讀金鑰,已停止卻仍有連線的 CT 要特別查);但只要同節點還有一台 CT 掛在舊連線上,清單裡那個舊 ID 就不會消失,要逐台確認各 CT 映像的連線是否換新。節點上 CT 很多時,以節點為單位處理最省事:VM 遷走,節點重新開機,處理完再跑一次清單,確認該節點的舊 ID 消失。這也是為什麼我建議跟著節點維護一起做。
PVE 以外建立的使用者
腳本只處理 PVE 自己管理的使用者。在客戶叢集上,收尾前的試跑多出這一段:
These keys need manual migration. Follow each client's key-rotation procedure;
update every key copy and refresh every client: client.samba
這是以前為了讓 Samba 分享 CephFS 而手動建立的使用者。先查它的權限(不印出金鑰),再查 CephFS 上還有沒有這個使用者的連線:
# 權限 (不印出金鑰)
ceph auth get client.samba -f json | perl -MJSON::PP -0777 -ne 'my $d=decode_json($_)->[0]; print JSON::PP->new->canonical->pretty->encode({entity=>$d->{entity},caps=>$d->{caps}})'

# 先用 ceph fs status 列出所有檔案系統與 active 的 MDS rank,每一個都要查
# CephFS 上有沒有這個使用者的連線 (cephfs1:0 換成檔案系統名稱與 rank)
ceph tell mds.cephfs1:0 client ls -f json | perl -MJSON::PP -0777 -ne 'my $n=0; for my $s (@{decode_json($_)}) { my $m=$s->{client_metadata}//{}; next unless ($m->{entity_id}//"") =~ /^(?:client\.)?samba$/; $n++; print JSON::PP->new->canonical->pretty->encode({id=>$s->{id},inst=>$s->{inst},metadata=>$m}) } print "NO_ACTIVE_SESSION\n" unless $n'
{
"caps" : {
"mds" : "allow rw",
"mon" : "allow r",
"osd" : "allow rw pool=cephfs1_data"
},
"entity" : "client.samba"
}
... client.718922111 ms_handle_reset on v2:10.0.0.9:6800/227667278
NO_ACTIVE_SESSIONms_handle_reset 是 ceph tell 本身的連線訊息,確認指令正常結束即可(輸出中的 IP 已替換)。NO_ACTIVE_SESSION 只代表沒找到 metadata 相符的 CephFS 連線,不是完整的身分盤點,還要搭配 monitor 的 sessions 有沒有這個使用者,以及實際系統的盤點。有多個檔案系統或多個 active MDS 時,每個 rank 都要查。沒有連線,也確認沒有任何系統還在用之後,先備份再刪除。備份檔含金鑰,先用 umask 077 讓檔案一建立就只有 root 能讀,並確認備份成功才刪除:
umask 077
BAK=/root/client.samba.keyring.bak-$(date +%Y%m%d-%H%M%S)
ceph auth get client.samba > "$BAK" && grep -q 'key = ' "$BAK" && ceph auth rm client.samba
如果這類使用者還在使用,就要依那個用戶端自己的程序換新金鑰:更新每一份金鑰副本、讓每個用戶端重新連線;用戶端還不支援的話,金鑰先不換、舊加密保持允許。
步驟三:收尾
清單清空之後,不加參數做最後一次試跑。檢查都通過時,它會印出最後要執行的那一行,通常是:
$H
$H --apply --confirm-all-clients-refreshed --restrict-ciphers這一步會讓新金鑰正式生效、撤銷舊金鑰,並拒絕舊加密的連線。腳本看得到的是目前連著的連線,離線的用戶端與外部的金鑰副本要自己確認,確認後再照它印出的那一行原樣執行。還在用舊金鑰的用戶端會被拒絕,而且已經連上的 I/O 看起來還會正常,直到它重新連線才失敗,所以這一步不能急。
完成後用下列指令確認,ceph health detail 不應再有 AUTH_INSECURE_*(輪替中的服務金鑰可能還要等它自然到期):
ceph -s
ceph health detail
pveceph auth status      # ceph auth ls 看不到待確認的金鑰,要用這個
pvesm status             # 只查執行的這個節點,每個用到 Ceph 儲存的節點都要跑
$H                       # 確認沒有待辦項目
還有用戶端不相容、想先暫停時,那個使用者的金鑰不換、舊加密保持允許,剩下的警告用 ceph health mute <代碼> 2w 這類加上期限的方式靜音(期限配合實際計畫),等用戶端升級完再回來做。只想先確認部分使用者,可以用 $H --confirm-clients-refreshed <使用者> --apply。
不能做的事
- 任何一個用戶端還沒換好就收尾
- 用
--force繞過 blocker - 刪除
/etc/pve/priv/cephx-key-migration.json:它記錄遷移進度,裡面也有舊金鑰,要保護好;遷移完成、所有用戶端都換好之前刪掉,中斷後就無法接續 - 手動
ceph auth rotate或手動限制加密類型 - 在多台節點同時執行
$H,或腳本執行期間做滾動重新啟動(腳本沒在跑的時候,分段期間照常做節點維護沒有問題,這正是前面「跟著維護慢慢完成」靠的機制)
出問題時
| 狀況 | 處理 |
|---|---|
| 執行中斷(斷線、節點重新開機) | 節點恢復後不加參數執行 $H,照它印出的下一步做;不要手動改進度記錄檔、keyring,也不要自行重建金鑰 |
| 想放棄某個使用者的新金鑰 | $H --abort-staged-key <使用者> --apply,讓所有用戶端換回舊金鑰,再執行 $H --confirm-abort-clients-refreshed <使用者> --apply |
| 收尾時限制加密類型錯誤,管理員被鎖在外面 | 金鑰本身仍有效、只是它的加密類型被禁止時,可以在 /etc/pve/ceph.conf 為 monitor 設 mon_auth_emergency_allowed_ciphers,這是啟動時才讀的設定,要逐台重新啟動 monitor(維持 quorum)才會生效(Ceph 會出現 AUTH_EMERGENCY_CIPHERS_SET);修好正常的允許清單後,拿掉設定再逐台重新啟動所有 monitor。手上的金鑰副本已被撤銷的情況救不回,要改用目前有效的管理金鑰 |
| 腳本一直無法繼續 | 先更新 pve-manager 再試,還是不行就聯絡 Proxmox 支援,再考慮 Ceph 原廠的手動程序 |
結論
這次的 cephx 警告看起來嚇人,實際上是一次可以排進日常維護的金鑰輪替。PVE 的遷移腳本把大部分細節都包好了,真正要花心思的是三件事:先確認服務真的重新啟動到新版、kernel 用戶端的版本夠新,以及在收尾前確定每一個用戶端都換好了。
遷移腳本的提示有一部分只到主機層級,客體一多就很難逐台判斷。用 monitor 的連線指紋對照 RBD 映像的使用者,就能列出哪些 VM、CT 的映像還掛在舊連線上,再配合「CT 以節點為單位」的觀察,安排起來就清楚多了。
參考資料
- Proxmox VE 管理指南:Migrate Cephx Keys from aes to aes256k
https://pve.proxmox.com/pve-docs/chapter-pveceph.html#pveceph_cephx_migration - Ceph:CVE-2025-30156
https://docs.ceph.com/en/latest/security/CVE-2025-30156/ - Ceph:Squid v19.2.6 and Tentacle v20.2.4 released
https://ceph.io/en/news/blog/2026/v20-2-4-v19-2-6-combo-released/ - Ceph:Cephx Upgrade(原廠手動程序)
https://docs.ceph.com/en/tentacle/rados/configuration/auth-config-ref/#cephx-upgrade