兩端的 IP 都對、DDNS 也沒錯,兩邊也都在送封包,VPN 卻斷了將近 8 小時,封包到底去了哪裡?
我的主站與異地備援機房各有一台 OPNsense,用 WireGuard 做 site-to-site VPN,兩邊都是 PPPoE 撥接,異地的監控、備份與 syslog 全靠這條通道。某天中午發現異地整個連不到,第一個直覺是異地 PPPoE 換了 IP、DDNS 沒跟上,結果完全猜錯。
最後在主站 PPPoE 底層的實體網路卡上抓封包,才看到真相:異地的回應其實有回來,只是帶著 PPPoE「舊連線」的編號,主站根本不會收。換一個埠號,10 秒就恢復。這篇記錄整個查修過程、原因推論,以及之後讓它自動恢復的做法。
環境與事故經過
文中的對外 IP 都換成文件專用的範例位址,主機名稱、DDNS 名稱也是範例,金鑰一律顯示為 <public-key>。終端機畫面是把實際指令輸出重新排版、替換位址後的結果,時間、封包長度與 session 編號都是實際數值。
| 項目 | 主站 fw-main | 異地 fw-branch |
|---|---|---|
| WAN | PPPoE 固定 IP 203.0.113.10,另有一條固定 IP 專線 WAN2 | PPPoE 浮動 IP 192.0.2.20,用 DDNS |
| WireGuard 監聽埠 | 51820 | 59820 |
| 對方端點 | 異地的 DDNS 名稱 | 主站的固定 IP |
| 內網 | 10.0.1.0/24 | 10.0.11.0/24 |
事後從主站閘道記錄整理出的時間軸:
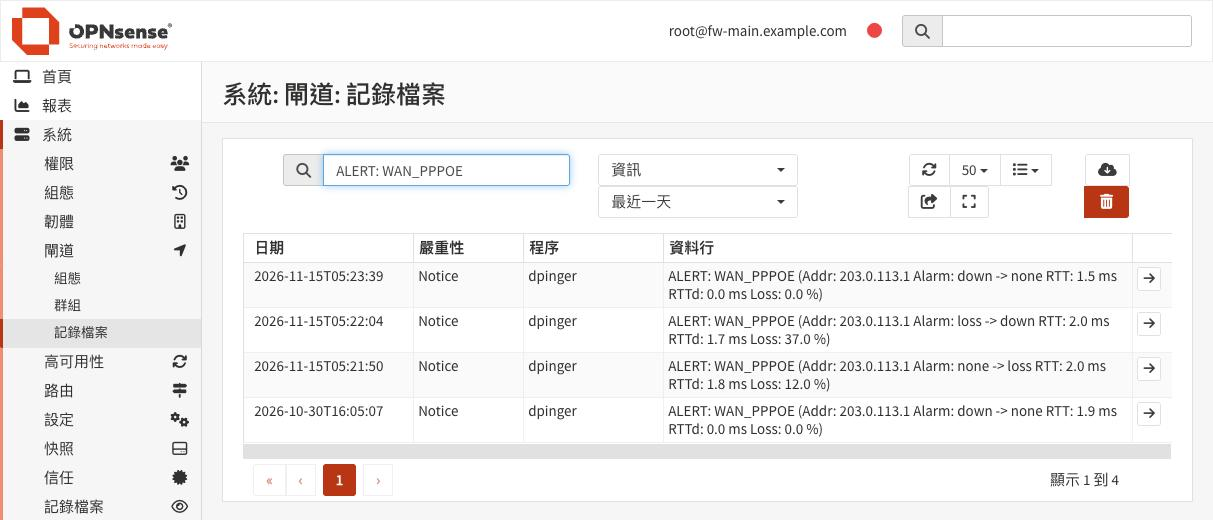
- 05:21:50
主站 PPPoE 閘道開始掉封包(Loss 12%) - 05:22:04
閘道監測判定 PPPoE 線路不可用(Loss 37%),預設閘道切到 WAN2,接著 PPPoE 連續重新撥號好幾次 - 05:23:39
PPPoE 恢復,預設閘道切回 PPPoE - 05:21 之後
WireGuard 的最後一次成功握手停在 05:21:21,之後再也沒成功過 - 11:30 左右
發現異地連不到,開始查修 - 13:27
找到原因,換埠號後 10 秒內恢復。從最後一次握手算起,中斷約 6 小時才發現,到恢復共約 8 小時
發現時的狀況:從主站 ping 異地內網與通道 IP 全部不通;主站的 WireGuard 大約每 5 秒送一次握手請求,但從來沒有收到回應。奇怪的是,主站自己上網、對外服務與其他站點的監控都正常,只有這條 VPN 斷了(經過 VPN 的異地監控當然也一起斷了)。
查修過程
懷疑 DDNS 沒跟上(錯)
主站先執行 OPNsense 內建的「重新解析 WireGuard 端點」:
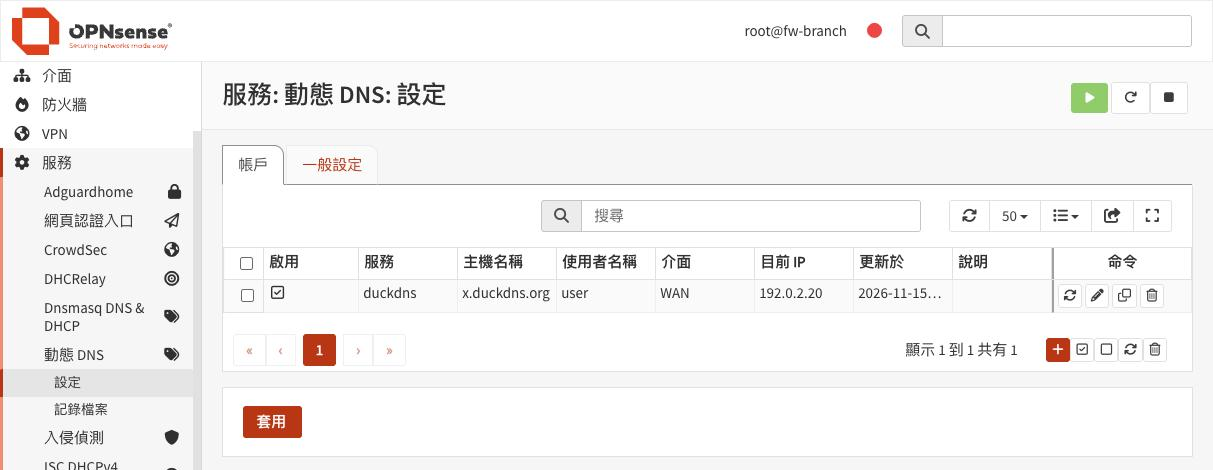
configctl wireguard renew這個動作對「超過 135 秒沒握手」的 peer,用設定檔裡的端點重新設定一次,名稱會重新解析。結果解析出來還是同一個 IP。到異地查「服務: 動態 DNS」,目前 IP 與異地實際的對外 IP 一致,DDNS 本來就是對的。
懷疑防火牆擋掉
異地 WAN 上放行 WireGuard 的規則,原本只允許主站特定的來源 IP。05:22 主站 PPPoE 斷線、預設閘道切到 WAN2 時,WireGuard 封包改從 WAN2 的 IP 送出,這段時間確實會被異地擋下。
但 05:23 PPPoE 就恢復了,之後主站都是從 PPPoE 的 IP 送出,照理說應該會通。清掉主站防火牆裡與異地相關的連線狀態也沒有改善(只需清這組 IP 的狀態,不必全部清除,以免中斷其他連線),所以這只是觸發點之一,不是一直不通的原因。
兩端同時抓封包
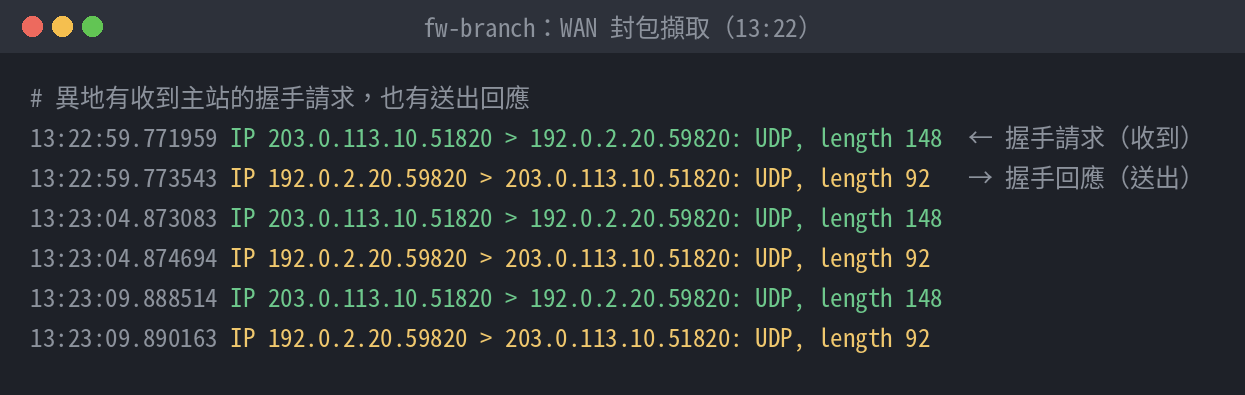
猜不出來就看證據。異地 WAN 抓封包,有收到主站的握手請求(148 bytes),也有送出回應(92 bytes):
主站在 pppoe0 上抓,卻只看得到自己送出的請求,異地的回應一個都沒有:
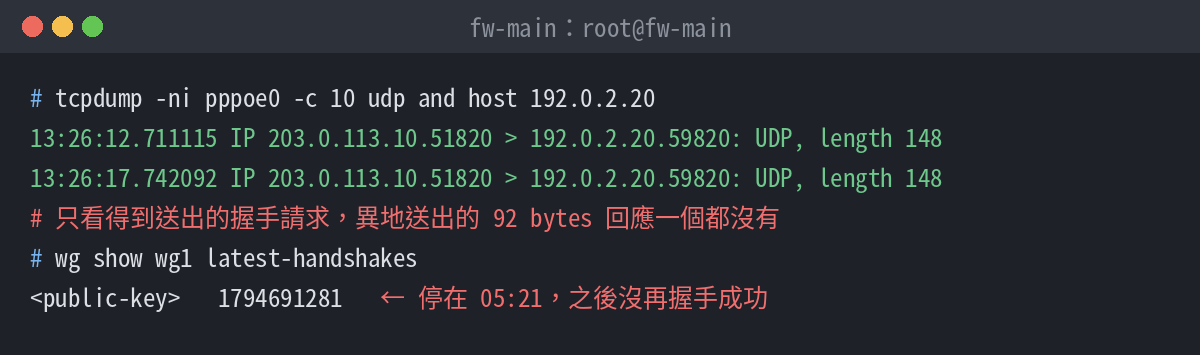
到這裡可以確定:封包是在「異地送出」到「主站 pppoe0 收到」之間不見的。
往下一層抓實體網路卡
PPPoE 是跑在實體網路卡(這台是 igb1)上面的,每一條 PPPoE 連線都有一個 session 編號。pppoe0 上看不到的封包,有可能還在實體網路卡上,所以直接在 igb1 抓 PPPoE 封包,pppoes 篩選條件會解開 PPPoE 的標頭再比對裡面的 UDP(實體介面帶 VLAN 標籤時,篩選條件要另外加上 vlan):
tcpdump -ni igb1 -c 8 'pppoes and udp port 51820'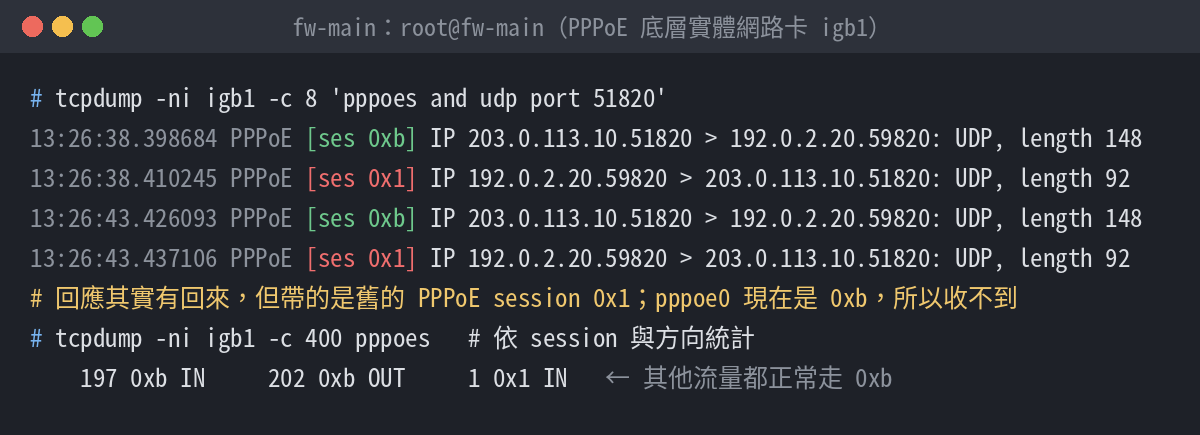
- 主站送出的封包是
ses 0xb,就是目前的 PPPoE 連線 - 異地回來的封包是
ses 0x1,不是目前的連線,依時間點推斷是重新撥號前的舊連線 pppoe0只接收0xb的封包,0x1的回應直接被丟掉- 同時間依 session 統計,其他流量進出都正常走
0xb,只有這組 WireGuard 的回應走0x1
原因:回應被送往舊的 PPPoE session
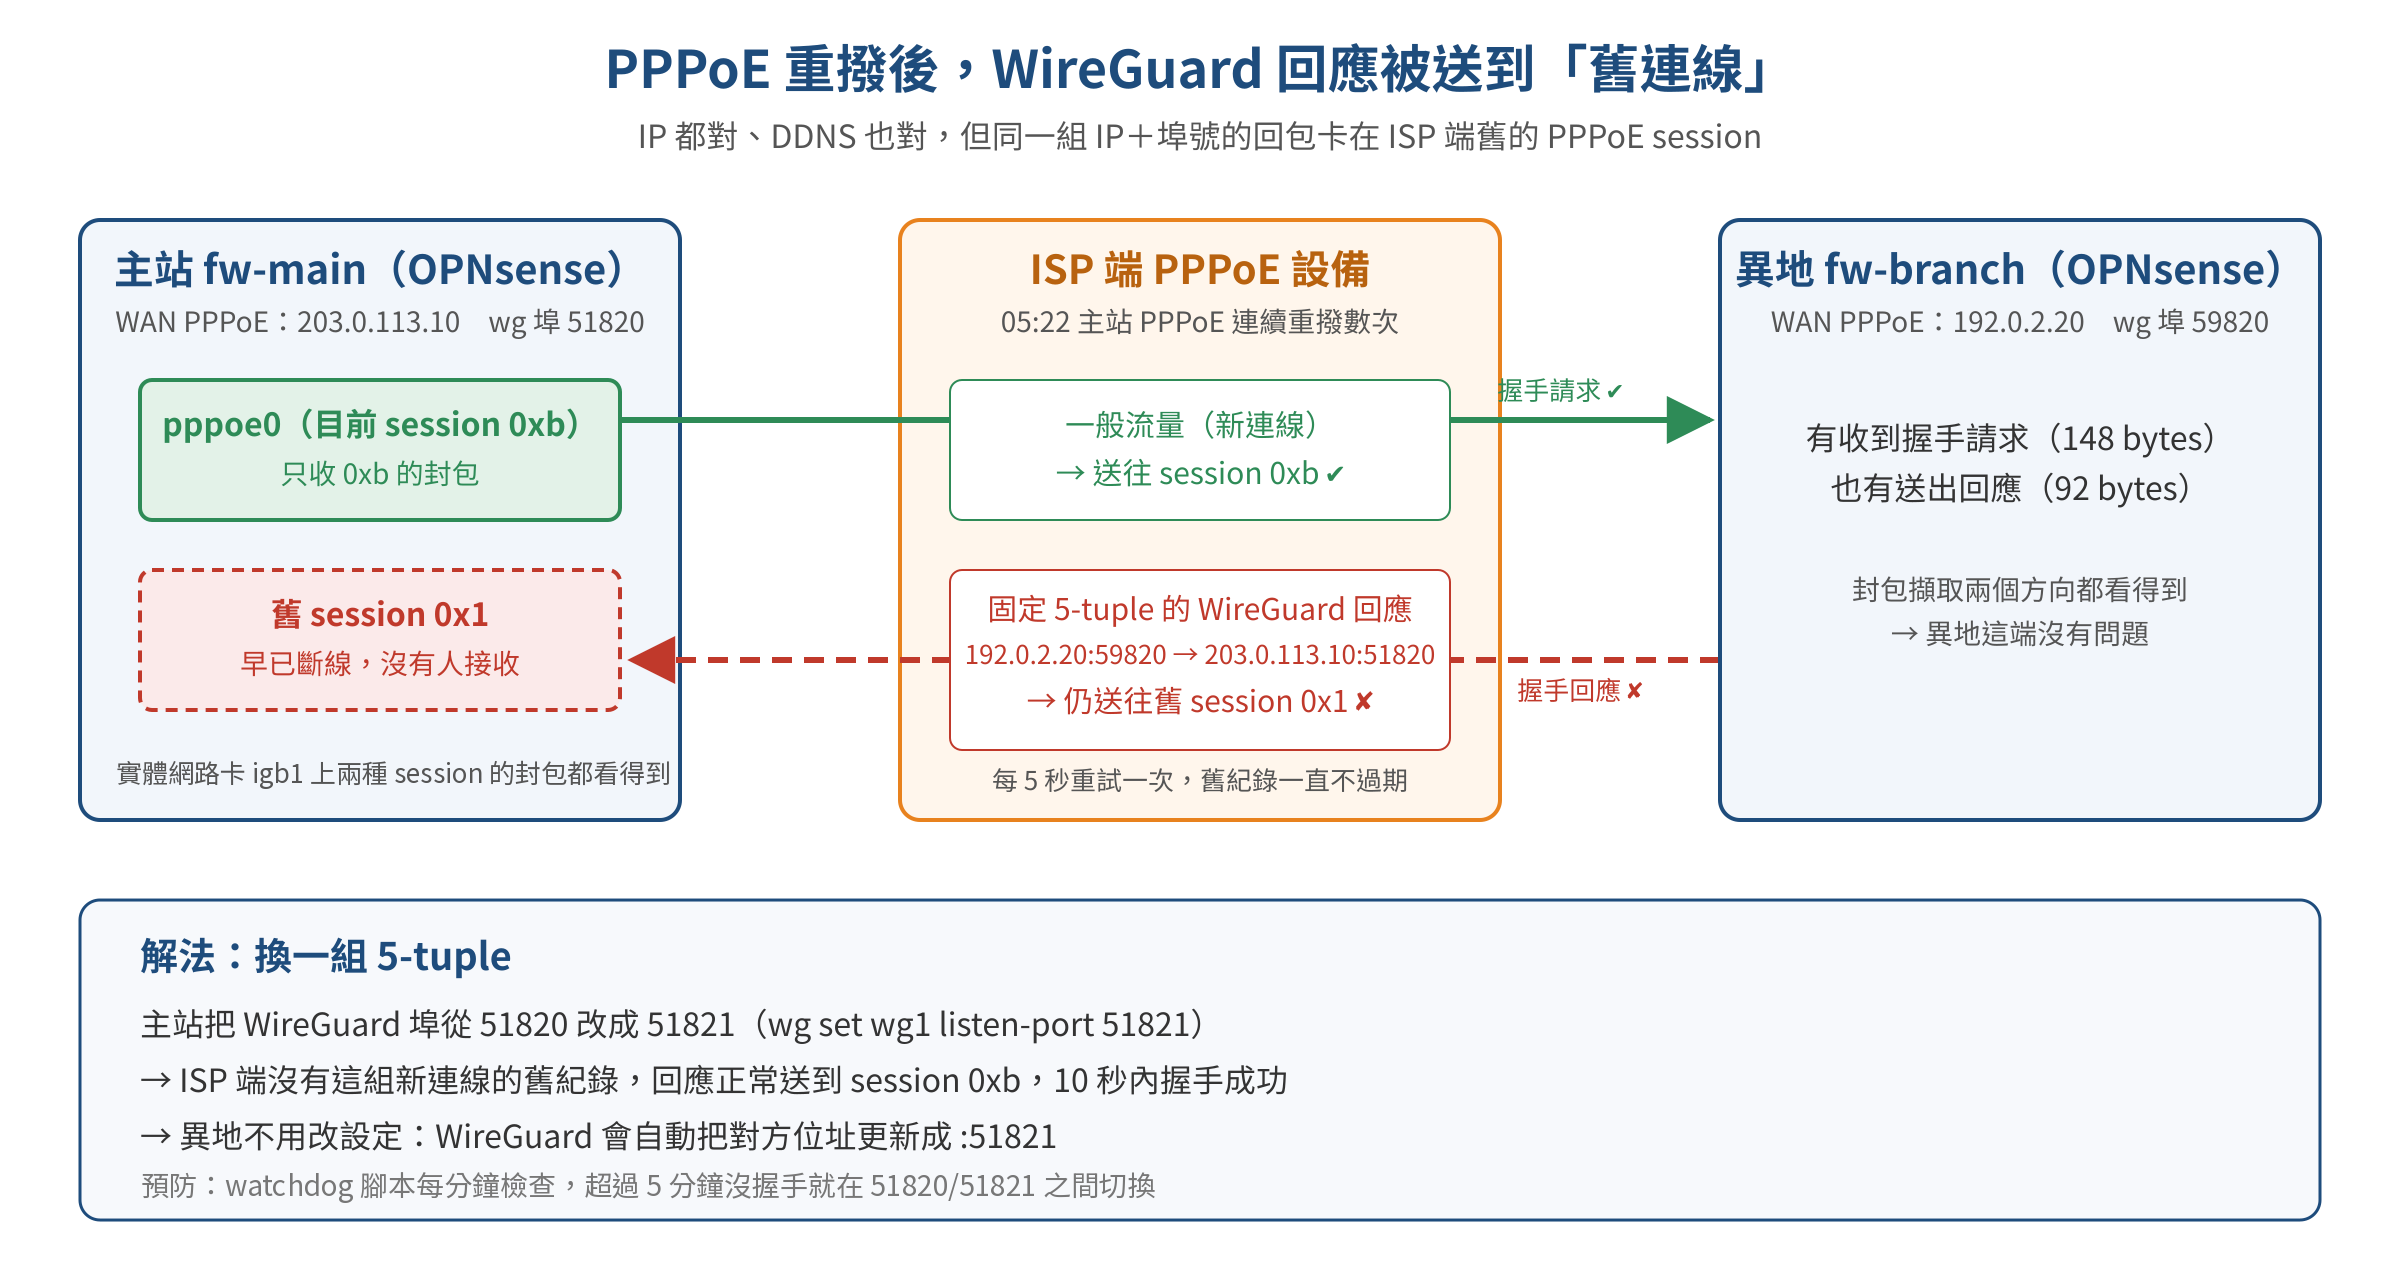
05:22 主站 PPPoE 短時間內連續重新撥號,原本的 session 是 0x1,最後穩定下來的是 0xb。之後 ISP 端對「同一組來源/目的 IP 與埠號」(加上協定,合稱 5-tuple)的回程封包,仍然送往舊的 session 0x1。我推測 ISP 端留有以連線為單位的轉送記錄,重新撥號時沒有清掉。
注意:ISP 內部怎麼實作我們看不到,上面是依封包推論。能確定的事實只有一件:同一個 IP 的回應封包,帶的是舊的 PPPoE session 編號。
如果推論成立,WireGuard 的運作方式剛好會讓這筆舊記錄一直不過期:
- 5-tuple 一直不變
PPPoE 恢復之後、手動換埠之前,兩邊的 IP、埠號都固定,失敗的這組流量始終是同一組來源與目的 - 握手失敗會一直重試
握手請求沒有回應時,WireGuard 大約每 5 秒(加上少許隨機延遲)重送一次,一輪重試沒成功會暫停;只要還有封包要送(監控、syslog,或設了 Keepalive),就會再觸發新的握手,這組 5-tuple 一直有流量,舊記錄的有效時間就一直被延長
一般新建立的連線多半會用新的來源埠,等於新的 5-tuple,就可能避開這筆舊記錄。這也可以解釋為什麼當時只有 VPN 斷、其他網路都正常。
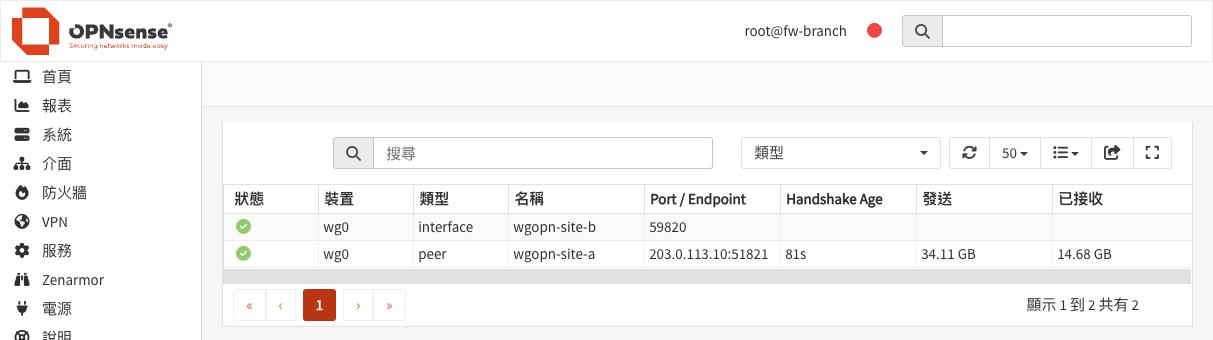
額外發現:異地的端點通訊埠填錯
整理截圖時發現,異地 peer 的「端點通訊埠」填的是 59820,這是異地自己的監聽埠,主站實際監聽的是 51820。
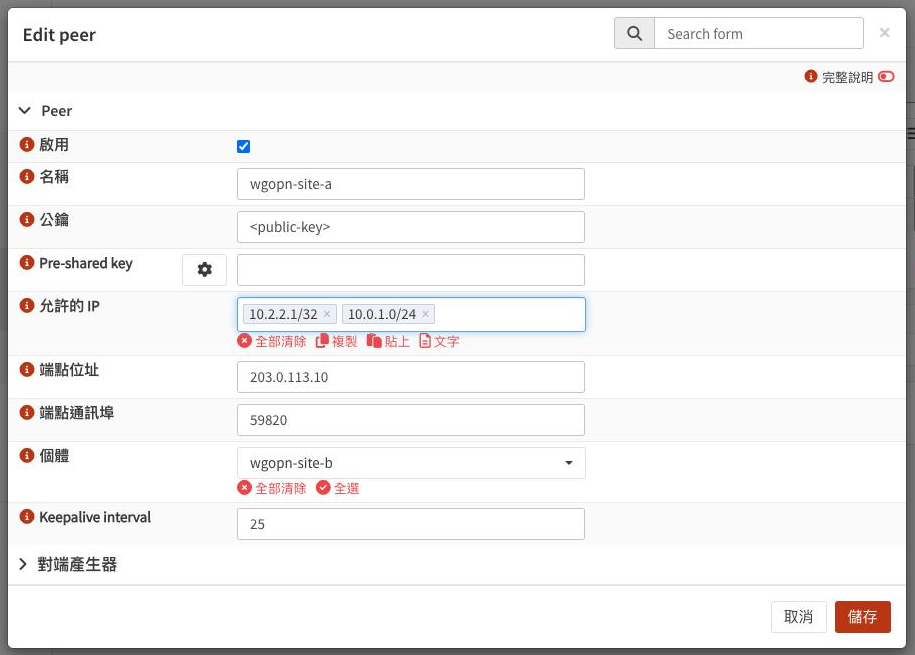
也就是說,異地照設定檔主動送出的握手請求,會送到主站沒有監聽的埠。平常感覺不到,是因為主站會主動連過去,異地收到合法的封包後,WireGuard 會自動改用封包的來源位址當作對方端點(roaming),之後異地主動發起的握手也就會成功。
這個自動學到的端點只存在執行中的狀態。我查了 OPNsense 目前的原始碼(2026/11),每次 WAN 取得新 IP(PPPoE 重新撥號也算),OPNsense 都會執行 wg syncconf,把端點設回設定檔裡的值。所以異地只要一重新撥號,就會回到那個錯的埠號,只能等主站來連。
這次異地送回主站的握手回應進不了主站的 WireGuard,異地照設定檔主動連線又送錯埠,兩條路同時斷掉,通道才會斷 8 小時。修正方式是把異地 peer 的端點通訊埠改成主站的 51820。
解法:換一組 5-tuple
既然問題綁在這組 5-tuple 上,換掉它就好。主站把 WireGuard 的監聽埠從 51820 改成 51821:
wg set wg1 listen-port 51821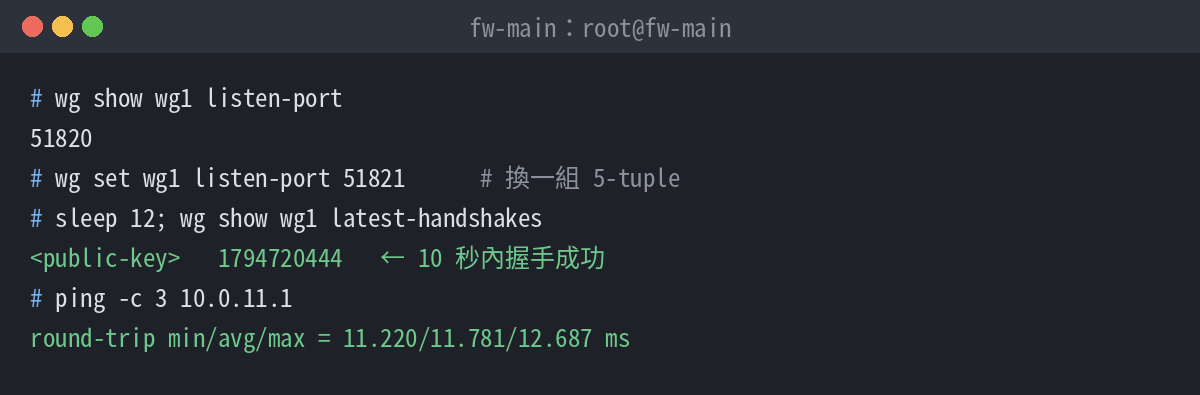
- 10 秒內握手成功
換了 5-tuple 之後,回應正常帶著0xb回來,也符合「舊記錄綁在原本那組 5-tuple 上」的推論 - 異地不用改設定
異地收到從新埠號送來的合法封包,會自動把主站的端點更新成:51821 - 主站防火牆不用另外開 51821
是主站主動往外送,異地的回應會對應到這條連線的狀態。但這只限主站先送出的情況:主站停在 51821 時,異地若重新載入設定,會照設定檔送往 51820 而失敗,要等主站的 Keepalive 送過去、異地重新學到端點才會接上 - 只是暫時的
wg set只改執行中的狀態,不會寫進設定檔;之後套用 WireGuard 設定、重新開機,或 WAN 取得新 IP 時的wg syncconf,都會回到 51820
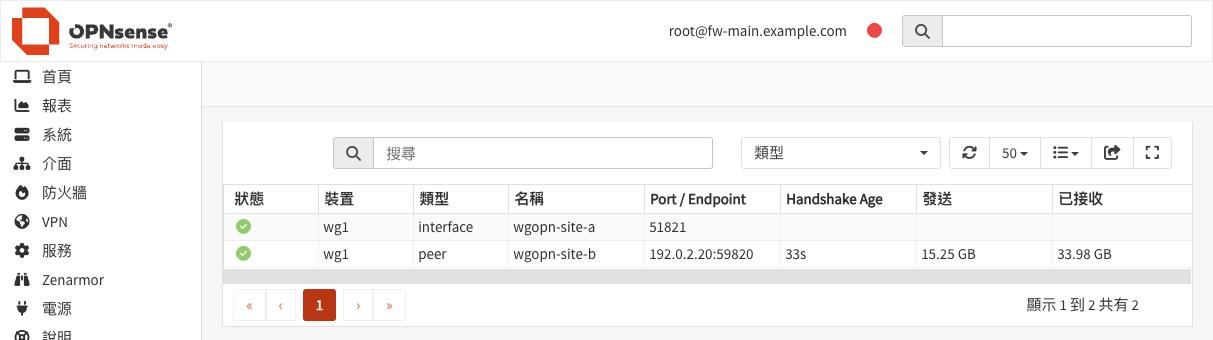
預防措施
目標是任何一邊 PPPoE 重新撥號、換 IP、切換閘道之後,都不用人處理就能自己接回來。
兩邊都設 Keepalive,端點填對方的埠
到「VPN → WireGuard → 端點」編輯對方的 peer,Keepalive interval 設 25。沒有流量時也會每 25 秒送一次,斷線後兩邊都會持續重試,哪一邊先通就由哪一邊接上。
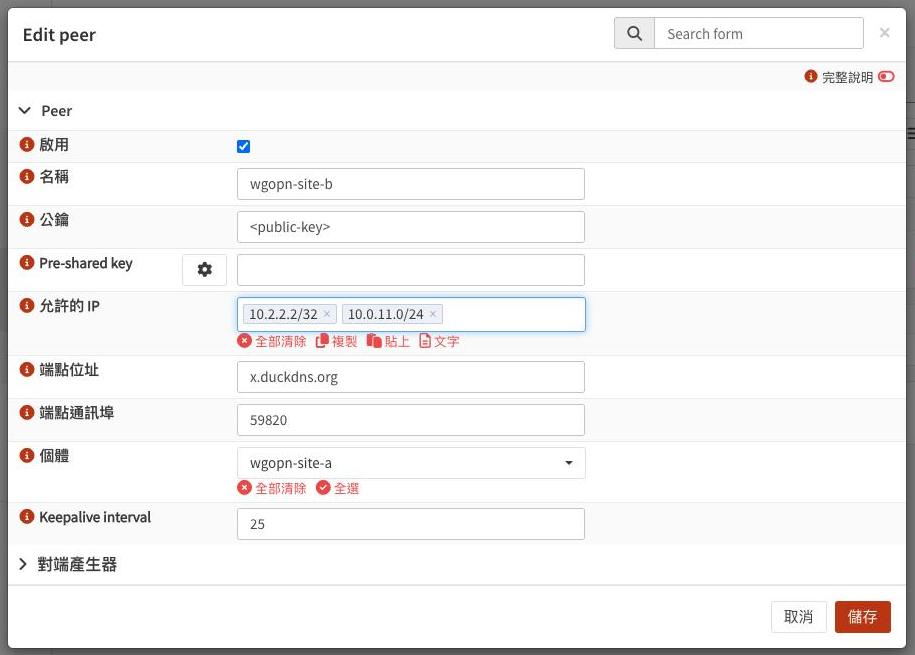
兩邊 peer 的端點位址與端點通訊埠,都要填「對方」的位址與監聽埠。填成自己的埠號不會有任何錯誤訊息,平常也靠對方主動連線撐著;但只要這一側從設定檔載入端點(例如重新撥號後的 wg syncconf),在重新學到正確端點之前,它的主動連線都不會成功。
浮動 IP 端主動連固定 IP 端
異地(浮動 IP)的端點指向主站的固定 IP,再加上 Keepalive,異地換 IP 後會馬上主動連回來,主站收到後自動更新對方位址,不必等 DDNS 更新與重新解析。
WireGuard 的防火牆規則不限制來源
原本只放行主站一個來源 IP,主站一切換線路就被擋。本例主站兩條線都是固定 IP,比較好的做法是建立別名,把兩個 IP 都放進去;對方是浮動 IP、無法列舉時,才把來源改成「任一」。我們這次先改成「任一」,主站不管從哪一條線路出去,異地都收得到。
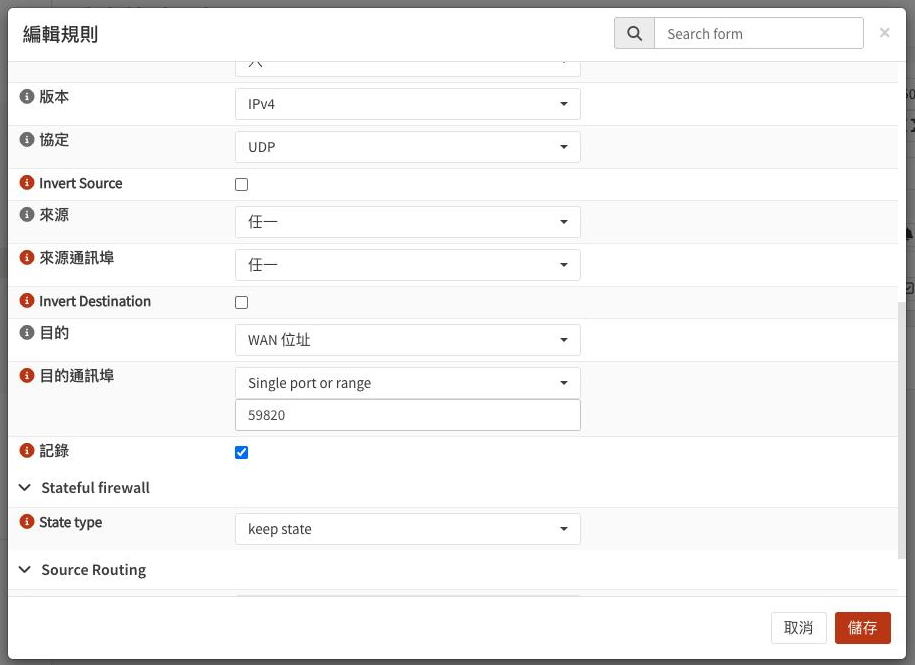
開放任一來源時要分清楚兩件事:沒有對應私鑰的人無法建立通道;隨機掃描因為不知道接收端的公鑰,算不出握手封包的驗證碼,WireGuard 也不會回應,看起來跟沒開這個埠一樣。但公鑰不是秘密,這個埠仍然會收封包、佔用一些處理資源,能限定來源時還是限定比較好。
自動換埠的 watchdog
這次在 IP 與設定的埠號都沒變的情況下,OPNsense 內建的功能(重新啟動 WireGuard、清連線狀態、重新解析 DNS)都換不掉 5-tuple。要依條件自動換埠,我用了一支自訂腳本。主站放一支 /usr/local/sbin/jt-wg-watchdog.sh:
#!/bin/sh
# WireGuard watchdog: if no handshake for MAX seconds, switch listen-port
# 51820 <-> 51821 (a new 5-tuple avoids a stale ISP flow mapping after
# PPPoE redial) and re-resolve peer DNS.
IF=wg1; A=51820; B=51821; MAX=300; HOLD=240
ST=/var/run/jt-wg-watchdog.last; ZF=/var/run/jt-wg-watchdog.zero
now=$(date +%s)
last=$(wg show $IF latest-handshakes 2>/dev/null | awk 'NR==1{print $2}')
[ -z "$last" ] && exit 0
if [ "$last" -eq 0 ]; then
  [ -f $ZF ] || { echo $now > $ZF; exit 0; }
  age=$((now - $(cat $ZF)))
else
  rm -f $ZF
  age=$((now - last))
fi
[ $age -le $MAX ] && exit 0
prev=$(cat $ST 2>/dev/null || echo 0)
[ $((now - prev)) -lt $HOLD ] && exit 0
cur=$(wg show $IF listen-port)
if [ "$cur" = "$A" ]; then new=$B; else new=$A; fi
wg set $IF listen-port $new
echo $now > $ST
logger -t jt-wg-watchdog "no handshake for ${age}s, listen-port $cur -> $new, renew dns"
/usr/local/sbin/configctl wireguard renew >/dev/null 2>&1
exit 0- 超過 5 分鐘沒有握手,就在 51820 與 51821 之間切換,並重新解析對方的 DDNS
- 切換後至少等 4 分鐘才會再切,不會來回跳;剛開機還沒握手時,從第一次執行算起等 5 分鐘才動作
- 每次切換都寫進 syslog(標籤
jt-wg-watchdog),送到集中記錄系統就查得到
要讓它出現在 OPNsense 的排程選單,建立 configd 動作檔 /usr/local/opnsense/service/conf/actions.d/actions_jtwg.conf:
[watchdog]
command:/usr/local/sbin/jt-wg-watchdog.sh
parameters:
type:script
message:JT WireGuard watchdog
description:JT WireGuard watchdog (switch port when handshake stale)
chmod 755 /usr/local/sbin/jt-wg-watchdog.sh
service configd restart
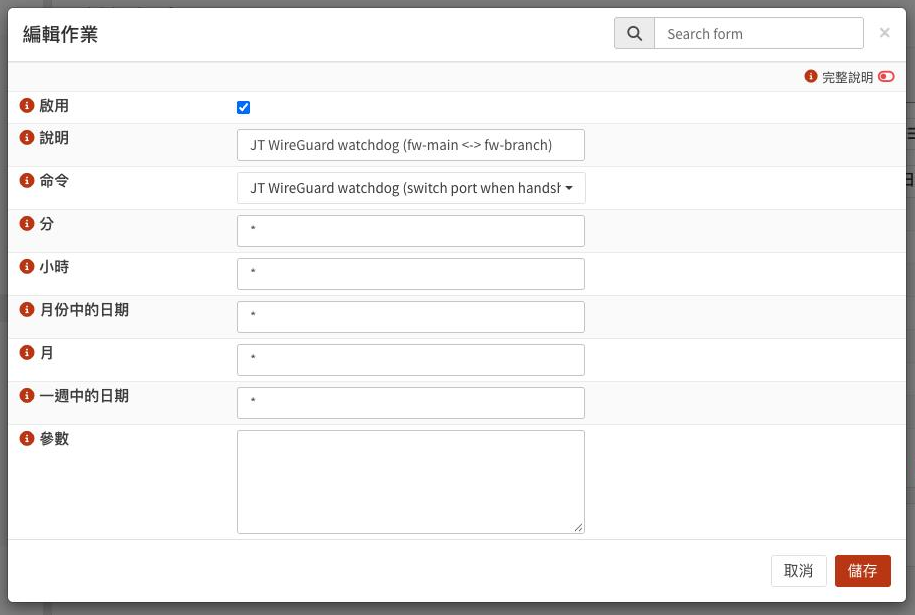
configctl jtwg watchdog # 手動測一次接著到「系統 → 設定 → Cron」新增作業,命令選「JT WireGuard watchdog (switch port when handshake stale)」,分、小時、月份中的日期、月、一週中的日期都填 *,也就是每分鐘執行。
使用前請注意這支腳本的適用範圍:
- 只看第一個 peer,但換的是整個介面
寫給一對一的 site-to-site 用;監聽埠是整個 WireGuard 介面的設定,介面上有多個 peer 時會一起受影響。介面名稱與埠號依自己的環境修改 - 換回原本的埠不保證有效
第一次換埠能避開舊記錄,但之後切回 51820 時又是原本那組 5-tuple;ISP 端的記錄多久會過期沒有公開資料。腳本也沒有檢查換埠是否成功,所以仍要有斷線告警,不能只靠它 - 要搭配 Keepalive
有 Keepalive 時通道正常就會定期重新握手;沒設的話,閒置太久也會被當成斷線而切換埠號 - 不在 OPNsense 的設定備份裡
腳本與動作檔是額外放進去的檔案,設定檔config.xml只記得那筆 Cron 作業;換機或重新安裝後還原設定,要另外把這兩個檔案放回去
其他建議
- 動態 DNS 更新快一點
檢查間隔調短,IP 取得方式選「介面」,直接從 PPPoE 介面取得位址,換 IP 後在下一次檢查時更新 - 留意 IDS 誤判
主站的 Suricata 把 WireGuard 封包判成ET MALWARE Possible KEYPLUG/Downadup/Conficker-C P2P encrypted traffic UDP Ping Packet(SID 2009206)。這條規則比對高埠號之間的加密 UDP,ET Open 預設是停用的;有啟用的話預設動作只是告警;但若啟用 IPS 模式,且這條規則經由政策改成 drop,命中的 WireGuard 封包就會被丟棄。建議針對這個 SID 與這組 IP 調整,不要整組 IP 都略過檢查 - 斷線要有告警
用 Monit 或監控系統 ping 對方內網,或對jt-wg-watchdog的 syslog 設告警。告警要從通道這一側發出,或偵測「多久沒收到對方資料」,因為對方的記錄與通知也走這條 VPN,斷線時送不出來。這次是斷了約 6 小時才發現
結論
這次最大的教訓是:「IP 都對」不代表封包到得了。一開始判斷成 DDNS 問題是錯的,兩端各抓一次封包,馬上就知道問題在中間那一段。PPPoE 環境還要再往下一層,pppoe0 上看不到的封包,可能還在實體網路卡上,只是帶錯了 session 編號。
WireGuard 固定的 5-tuple 加上不斷重試,讓錯誤的狀態一直維持下去,換一個埠號就是換一組 5-tuple。另一個體會是,兩邊都能主動連,才算真的有備援:這次異地的端點通訊埠填錯,平常靠主站單向撐著,一出事就沒有第二條路。
參考資料
- WireGuard:Protocol & Cryptography
https://www.wireguard.com/protocol/ - OPNsense 文件:WireGuard
https://docs.opnsense.org/manual/vpnet.html#wireguard - OPNsense 文件:Using configd
https://docs.opnsense.org/development/backend/configd.html - OPNsense 原始碼:WAN 取得新 IP 時同步 WireGuard(wireguard.inc)
https://github.com/opnsense/core/blob/master/src/etc/inc/plugins.inc.d/wireguard.inc - OPNsense 原始碼:重新解析端點(reresolve-dns.py)
https://github.com/opnsense/core/blob/master/src/opnsense/scripts/wireguard/reresolve-dns.py - tcpdump:pcap-filter(pppoes 篩選條件)
https://www.tcpdump.org/manpages/pcap-filter.7.html